robots.txt: как управлять обходом сайта

Файл robots.txt управляет обходом, но не показом: закрытая в нем страница все равно может попасть в выдачу, только без описания. Убирают страницу из поиска через noindex или пароль. Робот читает файл не так, как его писали: директивы применяются по длине правила, а не по порядку строк, и Disallow с Allow пересекаются неочевидно. Файл проверяют в валидаторе поисковой системы. Одна строка с ошибкой закрывает от обхода весь сайт.
Что robots.txt делает и чего не делает
Робот пришел на адрес и скачал содержимое страницы - это обход. Поисковая система разобрала скачанное, завела запись у себя в базе и допустила ее к показу по запросам - это индексация. Два разных события, которые путают постоянно.
Файл robots.txt управляет первым. На второе он влияет косвенно и не так, как от него ждут.
Что через него получится сделать:
- закрыть от обхода служебные разделы, которым в поиске делать нечего
- сберечь ресурс робота на большом сайте, где тысячи однотипных адресов с фильтрами забирают обход раньше, чем до него доходят товарные карточки
- указать адрес карты сайта
Чего не получится:
- убрать страницу из выдачи
- спрятать содержимое от людей и сборщиков данных
- помешать поиску узнать об адресе, на который ведет внешняя ссылка
Механика самая скучная. Обычный текстовый файл в кодировке UTF-8 лежит в корне домена, робот запрашивает его перед обходом и держит в кеше около суток.
Правила действуют строго в границах того хоста, протокола и порта, где файл лежит. Адрес `https://example.com/robots.txt` не управляет ни поддоменом `shop.example.com`, ни версией на `http`. Поддомен - отдельный сайт со своим файлом, и на большинстве проектов про него забывают. В подкаталог класть файл бессмысленно: роботы туда не заглядывают. У Google есть и лимит размера - 500 кибибайт. Все, что за ним, отбрасывается.
Экономия ресурса робота работает не везде. Сайту на двести страниц она не даст ничего: его обойдут целиком быстрее, чем вы успеете что-то настроить, сколько бы разделов ни закрыли. Смысл появляется от нескольких десятков тысяч адресов, когда фильтры, сортировки и внутренний поиск плодят комбинации быстрее, чем робот успевает их разбирать. Интернет-магазин в Алматы с тремя тысячами товаров и восемью фильтрами дает под миллион адресов - вот там запрет на обход комбинаций возвращает роботу время на карточки.
Когда файл недоступен, поведение роботов меняется. Ответ 4xx роботы Google читают как отсутствие файла: обход идет без ограничений. Ответ 5xx работает наоборот и жестко: первые 12 часов сайт не обходится вовсе, дальше в дело идет последняя удачно скачанная версия, и так до 30 дней. Сервер, который отдает 5xx на robots.txt во время переезда, тормозит обход всего сайта, хотя сами страницы открываются нормально.
Защитой robots.txt не работает. Стандарт держится на добровольном согласии, физической блокировки в нем нет. Крупные поисковые системы правила соблюдают, сборщики без репутации на них смотрят как на подсказку, где интересное. Сам файл открыт по прямому адресу любому желающему, так что строка `Disallow: /secret-project/` работает указателем. У роботов нейросетей своя логика допуска и свои имена - это отдельный разговор. Все, что нельзя показывать посторонним, закрывается паролем или авторизацией.
Какие директивы работают и какие ничего не делают
Устройство строки простейшее: имя директивы, двоеточие, значение. Регистр в названиях не важен, `User-agent` и `user-agent` работают одинаково. А вот в путях он учитывается: `Disallow: /Search/` не закроет `/search/`. Все после символа `#` роботы пропускают, это комментарий.
User-agent открывает блок правил и называет робота, для которого они написаны. Звездочка означает всех, у кого нет собственного блока в этом файле. Исключение: у Google звездочка не распространяется на роботов AdsBot, которые проверяют качество посадочных страниц в рекламе. AdsBot указывают отдельным именем, иначе общий запрет их не коснется.
Disallow запрещает обход по префиксу пути. Значение всегда начинается со слеша. Пустое значение (`Disallow:` и ничего дальше) запрета не создает, робот такую строку пропускает. Одинокий слеш (`Disallow: /`) закрывает сайт целиком. Две строки, отличающиеся одним символом, дают противоположный результат - на этом попадаются регулярно.
Allow делает исключение внутри запрета. Директива нужна, когда в закрытом разделе есть одна страница, которой место в выдаче.
Sitemap указывает адрес карты сайта. Полный, с протоколом и доменом. Директива не принадлежит ни одному блоку, действует на файл целиком, и таких строк может быть несколько. Про саму карту сайта есть отдельный разбор, здесь важна только строка.
Два спецсимвола расширяют работу с путями. Звездочка внутри пути заменяет любую последовательность символов, знак доллара обозначает конец адреса.
Без них правило работает по префиксу, и отсюда берется большая часть неожиданностей. Строка `Disallow: /catalog` закроет раздел каталога, а вместе с ним `/catalog-2024.html` и `/catalogue/`, если такой раздел заведется. Слеш в конце сужает правило до папки: `Disallow: /catalog/` затронет содержимое каталога и оставит открытым сам адрес `/catalog`. Знак доллара сужает до точного совпадения: `Disallow: /catalog$` закроет одну страницу и не тронет ничего внутри.
Пишите путь настолько длинным, насколько получается, и проверяйте новое правило на списке адресов до заливки. Короткое правило вроде `Disallow: /p` выглядит аккуратно ровно до дня, когда на сайте появится раздел `/price/`.
Остальные директивы, которые кочуют по шпаргалкам:
- `Clean-param` понимает только Яндекс. Директива говорит роботу игнорировать перечисленные параметры в адресе - метки рекламных кампаний, идентификаторы сессий. Для Google та же задача решается канонической ссылкой
- `Host` не учитывает ни Яндекс, ни Google. Директива устарела, зеркала определяются переадресацией и канонической ссылкой
- `noindex` внутри robots.txt не работает. Разбирая правила, парсер Google оставляет только `User-agent`, `Allow` и `Disallow`, остальные строки выбрасывает
Рабочий пример файла для небольшого сайта:
# robots.txt для example.com

# Общий блок: для всех роботов, у которых нет своего блока ниже
User-agent: *
Disallow: /search/          # внутренний поиск по сайту
Disallow: /cart/            # корзина
Disallow: /account/         # личный кабинет
Disallow: /admin/           # панель управления
Disallow: /*?sort=          # сортировка каталога
Allow: /account/dostavka/   # условия доставки нужны в выдаче

# Карта сайта: полный адрес, вне блоков, действует на весь файл
Sitemap: https://example.com/sitemap.xml
Под запрет здесь попал типовой набор служебных разделов и параметров. Такие адреса плодятся сотнями, содержимого для выдачи в них нет, а обход они забирают.
Почему робот читает файл не так, как его писали
Сверху вниз файл не читается почти никогда. У робота свой порядок разбора, и отсюда берется большинство поломок.
Робот выбирает один блок. Тот, где его имя названо наиболее точно. Остальные он игнорирует, включая общий со звездочкой: личный блок с общим не складывается.
Самая частая поломка файла не выглядит поломкой:
User-agent: Yandex
Disallow: /test/

User-agent: *
Disallow: /search/
Disallow: /cart/
Disallow: /admin/
Автор рассчитывал, что для Яндекса к общим запретам добавится еще один. Робот прочитает только первые две строки. Внутренний поиск, корзина и панель управления для него открыты - все три раздела он обойдет и отправит в индекс. Справка Яндекса говорит об этом прямо: если в файле есть блок для его робота, строка `User-agent: *` игнорируется. У Google логика та же. Завели отдельный блок - продублируйте в нем все, что должно действовать на этого робота.
Несколько блоков с одним и тем же именем робот объединит в один. Три блока `User-agent: Googlebot` в разных концах файла соберутся вместе.
Порядок строк внутри блока не важен. Робот сортирует правила по длине пути и применяет самое точное совпадение. Если длина совпала, побеждает `Allow`. У Google и Яндекса здесь одинаковая механика, хотя описана она в справках разными словами.
Как это выглядит на конкретных адресах:
- для `/page` правила `Allow: /p` и `Disallow: /` дают обход: путь в разрешении длиннее
- для `/folder/page` правила `Allow: /folder` и `Disallow: /folder` дают обход: длина равная, побеждает разрешение
- для `/page.htm` правила `Allow: /page` и `Disallow: /*.htm` дают запрет: второе совпадение точнее
Строка Sitemap внутри блока склеивает его с соседним. Парсер выбрасывает все, кроме трех директив, и два блока, разделенные только выброшенной строкой, становятся одним:
User-agent: Googlebot
Sitemap: https://example.com/sitemap.xml

User-agent: Googlebot-Image
Disallow: /
Автор закрывал от обхода картинки. Робот прочитает это как один блок для двух имен, и запрет ляжет на весь сайт: обход остановится, страницы начнут выпадать, а причина будет выглядеть безобидной строкой с адресом карты. Держите строку Sitemap в конце файла, отдельно от блоков.
Чем убирают страницу из поиска вместо robots.txt
Задача «убрать страницу из выдачи» решается не в robots.txt. Инструментов три, и они не взаимозаменяемы.
Метатег robots со значением noindex. Страница уходит из выдачи после того, как робот придет и прочитает тег. Отсюда обязательное условие: обход этой страницы должен быть разрешен.
Заголовок ответа X-Robots-Tag. То же самое, но на уровне сервера. Годится для файлов, куда метатег не поставить: документы PDF, изображения, архивы.
Авторизация или пароль. Единственный вариант для того, что не должно попасть посторонним на глаза ни при каких условиях.
Здесь и ошибаются: страницу закрывают в robots.txt и заодно вешают на нее `noindex`, для надежности. Надежности не выходит. Робот не приходит на страницу, тега не видит, а адрес продолжает висеть в выдаче. Яндекс пишет об этом в справке отдельным предупреждением: страницы, которые нужно удалить из поиска, ограничивать в robots.txt не надо, иначе робот не обнаружит указание. У Google результат тот же - содержимое не индексируется, а адрес показывается без описания.
Правильный порядок для страницы, которая уже в поиске:
- снять с нее запрет на обход
- поставить метатег `noindex` или заголовок ответа
- дождаться переобхода, при необходимости ускорить его в панели вебмастера
- убедиться, что страница ушла из выдачи, и только после этого решать, нужен ли запрет обхода вообще
Сайт на несколько тысяч страниц проходит этот круг за недели, не за дни. Подробнее про сроки и причины - в разборе, почему страниц нет в поиске.
Четыре ошибки, из-за которых сайт пропадает
Каждая встречается на проектах любого размера - от лендинга мастерской в Ташкенте до каталога на сорок тысяч адресов.
Disallow: / приехал с тестового сервера
Классика переезда. Пока сайт собирали, тестовая версия была закрыта от обхода целиком, и это правильно. Потом файлы выложили в рабочую версию как есть.
Симптом: трафик из поиска сыплется за несколько дней. В Яндекс Вебмастере на панели загорается критичная ошибка о том, что сайт закрыт от индексирования. В Google Search Console страницы уходят в отчет о заблокированных файлом адресах.
Что делать: убрать строку и дождаться, пока роботы перечитают файл. Яндекс сделает это при следующем обращении к сайту, Google держит копию в кеше около суток. Страницы возвращаются в индекс по мере переобхода, и на большом сайте это растягивается.
Закрыты стили и скрипты
Наследство эпохи, когда файлы оформления закрывали от обхода, чтобы «не тратить обход на ерунду». Сегодня поиск рендерит страницу примерно как браузер: подтягивает оформление, выполняет скрипты и смотрит на результат. Без стилей на выходе получается набор текста без структуры, и оценка страницы падает.
Увидеть это можно в инструменте проверки URL: отрендеренная копия страницы не похожа на то, что открывается у человека в браузере. Мобильная версия теряется целиком.
Что делать: открыть каталоги со стилями, скриптами и шрифтами - отдельными строками `Allow`, если общий запрет нужен по другим причинам.
Файлом пытались скрыть личные данные
Раздел с договорами, выгрузками или персональными страницами клиентов закрыли от обхода и посчитали задачу решенной.
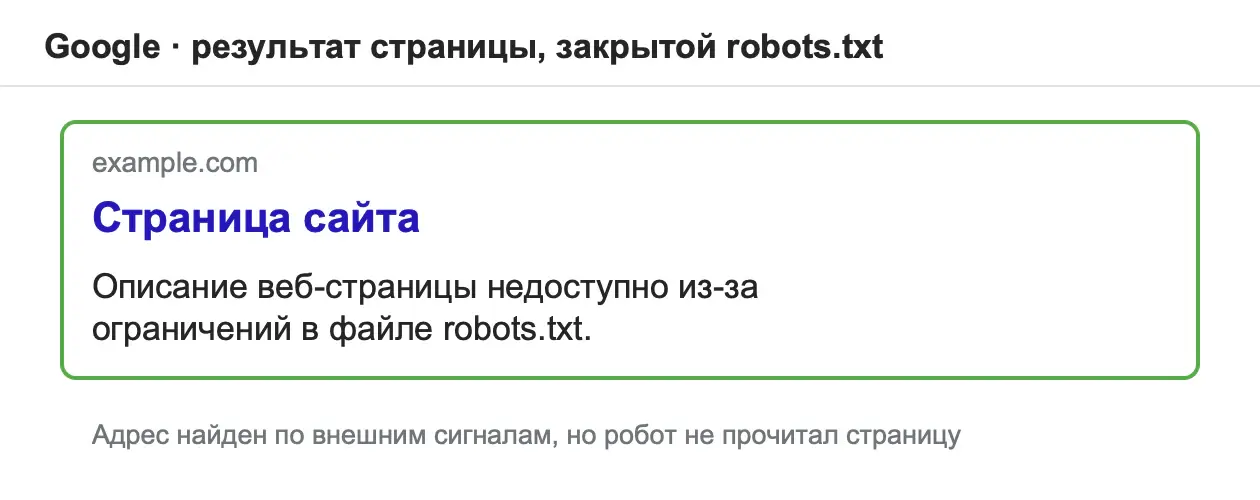
Итог: адрес нашелся в выдаче. Описания нет - вместо него текст о том, что информация недоступна из-за ограничений в robots.txt. Поисковая система собрала запись по внешним ссылкам и их тексту.
Единственный способ - закрывать авторизацией. Заодно проверить, откуда взялись ссылки: часто это карта сайта, которую никто не чистил, или ссылка из письма, попавшая в открытый чат.
Закрыт раздел, внутри которого стоят канонические ссылки
Ситуация тоньше предыдущих и держится на сайтах годами. Раздел с фильтрами или страницами сортировки закрыли от обхода, чтобы разгрузить робота. Внутри раздела на каждой странице аккуратно проставлена каноническая ссылка на основную карточку.
В раздел робот не заходит, канонических ссылок не читает и указания склеить дубли не получает. Дубли остаются дублями, а ошибка консервируется: снаружи все выглядит настроенным.
В отчетах панелей при этом растет число страниц с пометкой о дублировании, хотя канонические ссылки на сайте стоят и выглядят рабочими.
Выбрать придется что-то одно. Либо обход раздела разрешен и канонические ссылки работают, либо раздел закрыт, а дубли убираются структурой адресов.
Как проверить файл до публикации
Проверка занимает пять минут, и делать ее надо до заливки.
Яндекс Вебмастер, раздел «Инструменты», пункт «Анализ robots.txt». Инструмент показывает содержимое файла и проверяет его на ошибки. Полезнее всего нижний раздел «Разрешены ли URL?»: вставляете список адресов, и по каждому видно, разрешен обход или запрещен, а если запрещен - какое правило сработало. Содержимое файла в поле правится руками. Новую редакцию можно прогнать до того, как она попадет на сайт. Права на сайт для проверки не нужны.
Google Search Console. В настройках лежит отчет по файлу robots.txt: какую версию видит Google, когда он читал ее в последний раз и нашлись ли при разборе ошибки. По конкретному адресу инструмент проверки URL показывает статус блокировки и отрендеренную копию страницы.
Диагностика в Яндекс Вебмастере. Запрет обхода всего сайта попадает в критичные проблемы, метка видна на главной панели, и на почту приходит письмо. Уведомления стоит включить: это единственный канал, по которому о такой поломке узнают в первые сутки, а не через месяц по просевшему трафику.
Остается способ, для которого не нужна ни одна панель. Откройте `/robots.txt` своего сайта в браузере и прочитайте файл целиком, строку за строкой. Панели показывают то, что в них ввели. Файл отдает то, что накопилось за годы: запреты от прошлых подрядчиков, закрытые черновики, которые давно опубликованы, правила для разделов, которых больше нет.
Дальше пара минут на конкурентов. Чужой robots.txt открыт так же, как ваш. Видно, какие разделы закрыты от обхода, а строка `Sitemap` ведет прямо к списку всех страниц сайта - удобный способ посмотреть структуру каталога и темы блога целиком. Проверка файла входит в базовый чек-лист SEO-аудита и стоит там одним из первых пунктов.
robots.txt на Тильде: что там по умолчанию
Конструктор генерирует robots.txt автоматически, и текстового редактора для этого файла нет. Управление косвенное, через настройки.
Запрет на обход отдельной страницы ставится в ее настройках: раздел «Facebook & SEO», блок отображения в поисковой выдаче, галочка запрета индексации. После публикации в файле появляется строка `Disallow` с адресом этой страницы. Запрет на весь сайт стоит в настройках сайта, в разделе SEO, и дает `Disallow: /` для всех роботов сразу.
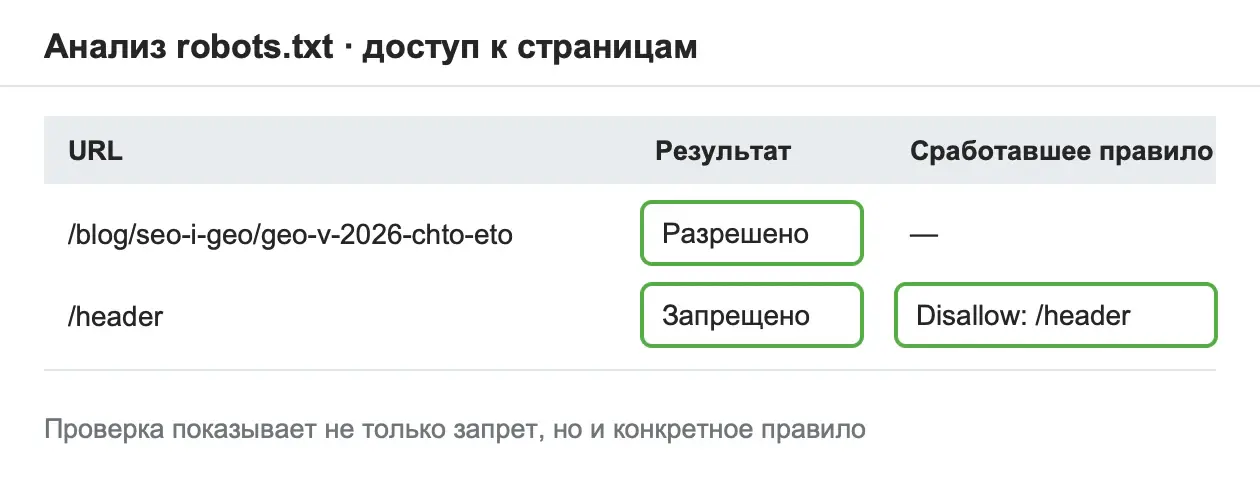
Так выглядит robots.txt этого сайта - он собран конструктором целиком, руками в нем не тронуто ни одной строки:
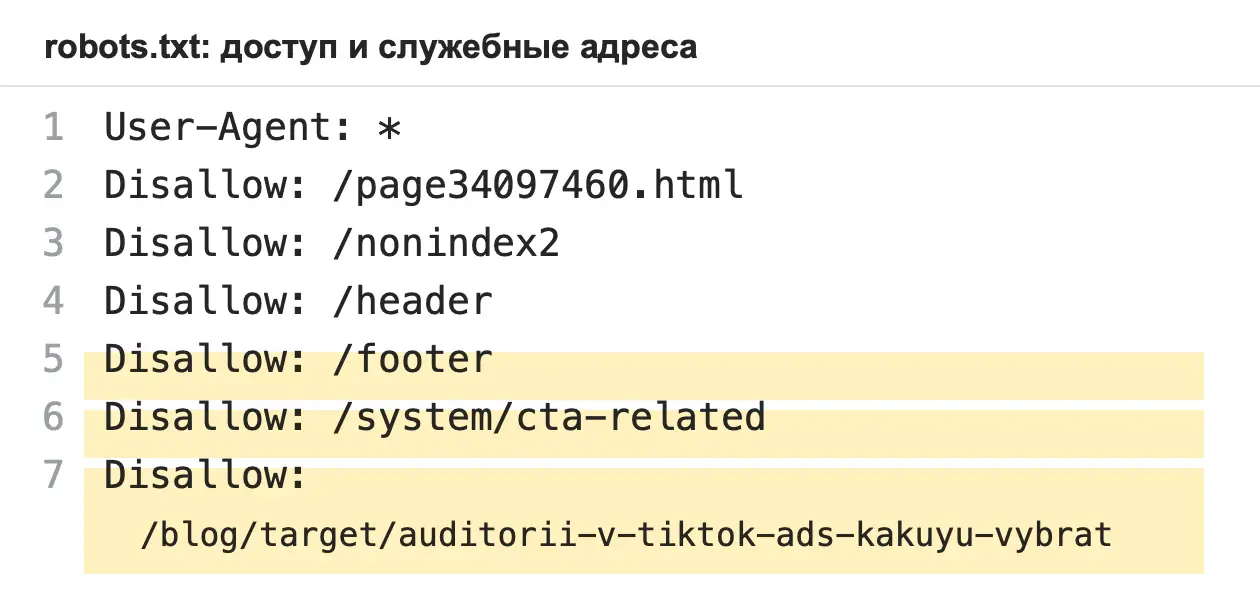
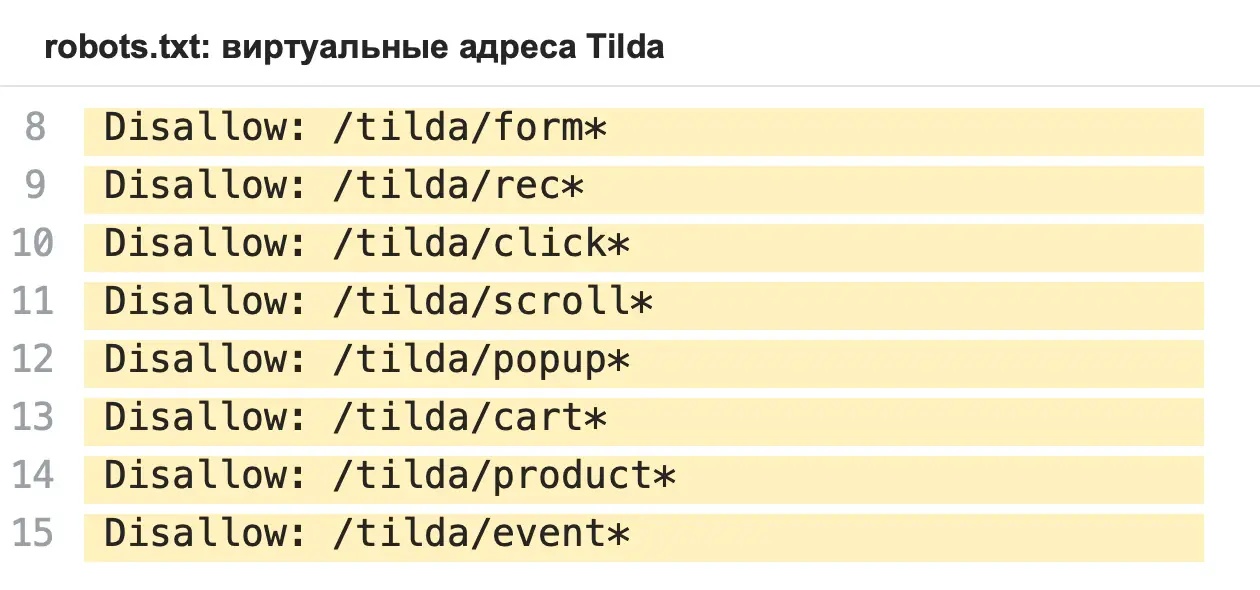
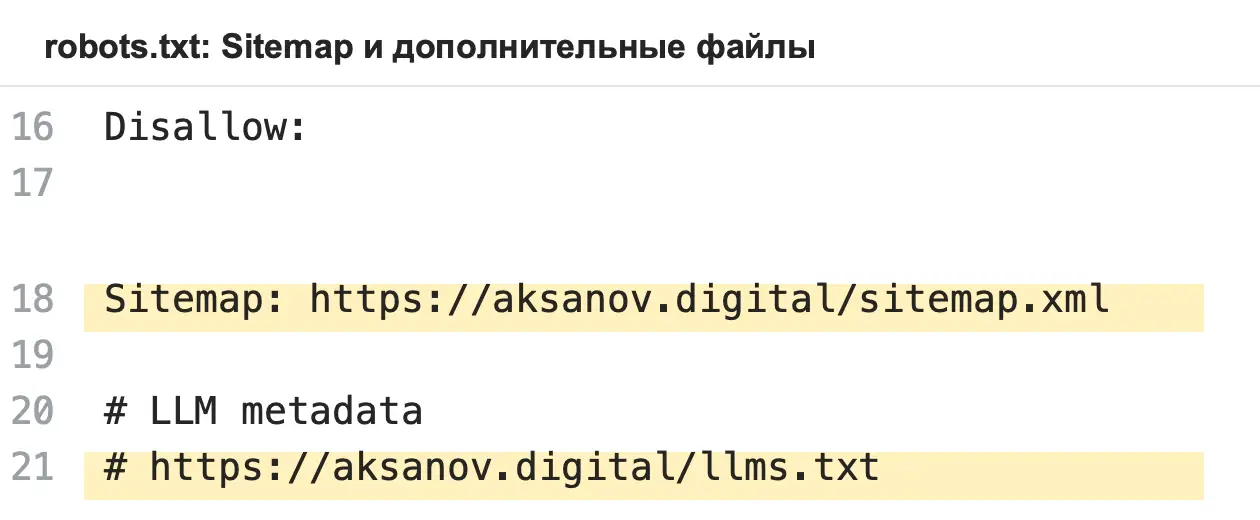
Весь файл - один блок `User-Agent: *`. Отдельных блоков для роботов Google и Яндекса конструктор не делает, добавить их некуда. Значит, `Clean-param` для Яндекса здесь недоступен, с параметрами в адресах справляется каноническая ссылка. Конструктор пишет `User-Agent` с двумя заглавными - в названиях директив регистр не учитывается, роботам это безразлично.
Адреса вида `/page34097460.html` - страницы, закрытые галочкой. Конструктор записывает их системным именем по внутреннему номеру, а если у страницы задан собственный адрес, в файл попадает и он. Туда же уходят технические страницы проекта: шапка, подвал, архивная страница, блоки для всплывающих окон.
Восемь строк с `/tilda/` конструктор ставит сам, набор зависит от подключенных функций. Это виртуальные адреса, которые конструктор подставляет при отправке формы, клике, прокрутке, показе всплывающего окна и действиях с корзиной, чтобы такие события считались целями в системах аналитики. Страниц за ними нет, обходить там нечего.
Пустой `Disallow:` в самом низу не запрещает ничего. Правило без пути роботы пропускают.
Карта сайта прописывается сама: строка `Sitemap` ведет на автоматически собранный список страниц. Ниже нее две строки с решеткой, в них закомментирован адрес файла llms.txt. Поисковые роботы этих строк не видят - все после решетки они пропускают.
Адресов с `/members/` в примере нет - они появляются, когда на сайте включен личный кабинет для пользователей.
Отдельная история - технический адрес. Любой проект на конструкторе доступен по служебному имени вида `project12345.tilda.ws`, и после привязки своего домена оба адреса продолжают отдавать одни и те же страницы. Служебное имя - отдельный поддомен со своим файлом robots.txt, которым вы не управляете. Правила рабочего домена на него не действуют, так что закрывать копию через robots.txt бесполезно: вопрос решается канонической ссылкой, которая настраивается в разделе SEO настроек сайта.
Главная проблема конструктора не в ограничениях, а в накоплении. Галочка ставится один раз, строка в файле остается навсегда. Страница висела черновиком со скрытым адресом, потом вышла в свет, галочку никто не снял - и обход ей закрыт. В файле выше есть ровно такая строка: под запретом стоит статья блога, которая давно опубликована. Ни одна панель об этом не сообщает, с точки зрения конструктора все настроено так, как попросили. Для сайтов на конструкторе спасает только ручная сверка: после каждой большой публикации открывайте файл глазами и сверяйте список запретов со списком страниц, которые вы вправду прячете.
Что проверить за пять минут
- открыть свой `/robots.txt` в браузере и прочитать целиком, сверяя каждую строку запрета с тем, что она закрывает сегодня
- прогнать десяток важных адресов через анализ файла в Яндекс Вебмастере и убедиться, что обход им разрешен
- снять запрет обхода со страниц, которые закрыты и в файле, и метатегом `noindex`
Обход и индексация - разные события. Файл управляет обходом. Присутствием в выдаче управляют метатег, заголовок ответа сервера и авторизация.
Частые вопросы
Нужен ли robots.txt, если закрывать нечего
Строго обязательным файл не считается: без него роботы обходят сайт целиком, и для десяти страниц этого достаточно. Но каждое обращение робота за файлом упирается в 404, а строку `Sitemap` ставить некуда. Минимальный файл из трех строк - общий блок, пустой `Disallow` и адрес карты сайта - стоит десяти минут работы.
Почему страница закрыта в robots.txt, а в поиске она есть
Потому что запрет касается обхода, а не показа в выдаче. Если на страницу ведут внешние ссылки, поисковая система соберет запись по ним: адрес и текст ссылок у нее есть, содержимое страницы - нет. Такая запись показывается без описания. Убирают такой адрес иначе: обход разрешают, а на страницу ставят метатег `noindex`.
Можно ли писать noindex внутри robots.txt
Нет. Google перестал учитывать такую строку, а его парсер выбрасывает из файла все неизвестные ему директивы. Строка `Noindex: /page/` не сделает ничего. Метатег `noindex` ставится в код страницы, в элемент `head`.
Как закрыть сайт на время разработки и не забыть открыть
Надежнее всего закрывать тестовую версию авторизацией на уровне сервера: тогда файл robots.txt рабочей версии нечему испортить. Если закрываете строкой `Disallow: /`, поставьте задачу на снятие запрета в тот же список, где лежит сам переезд, и первым действием после публикации откройте `/robots.txt` глазами. Взгляд на файл занимает секунды, а поиск ошибки постфактум - недели.
Обязательна ли строка Sitemap, если карта уже отправлена в панели
Не обязательна, но пусть будет. Панель работает для одной поисковой системы, а строка в файле видна всем роботам, включая тех, кому карту никто не отправлял. Места она занимает одну строку, требует полный адрес с протоколом и ставится вне блоков.
Нужны ли разные блоки для Google и Яндекса
Чаще всего нет - общего блока со звездочкой хватает. Отдельный блок нужен, когда правила действительно расходятся: например, для Яндекса добавляется `Clean-param`, которого Google не понимает. Заводя такой блок, повторите в нем все общие запреты. Робот с личным блоком читает только его, а общий пропускает целиком.