Дубли страниц: как найти и закрыть


Дубли мешают не всегда: проблема появляется тогда, когда две страницы начинают бороться за один запрос или когда бюджет обхода уходит впустую. Технические и смысловые дубли лечатся разными способами, и путать их нельзя. Технических источников шесть - слеш на конце адреса, www, протокол, параметры сортировки, фильтры и пагинация. Смысловые дубли вылавливают через срез запросов в Search Console. Технические дубли склеивают каноническим тегом на главную версию.
Когда дубли страниц мешают продвижению, а когда нет?
Дубли страниц мешают, когда по целевому запросу поиск показывает не тот адрес, когда копий сотни и свежие материалы неделями ждут индекса или когда на копию ведут внешние ссылки. Если поиск уже выбрал правильный адрес или копий единицы, их можно оставить. Санкций за собственные дубли нет: поиск склеивает адреса и выбирает один.
«Дубли вредят продвижению» - фраза из каждой второй статьи по теме, и она ничего не объясняет. Полезнее разобрать, что происходит с сайтом.
- Сигналы делятся между адресами. Внешние ссылки, поведение людей, накопленный возраст привязаны к конкретному адресу. Когда материал открывается по двум адресам, вместо одной сильной страницы выходят две средние.
- Робот тратит обход на копии. Есть предел тому, сколько адресов поисковый робот готов скачать за визит. Копии этот предел съедают, а свежие материалы ждут очереди. Про индексацию и обход сайта есть отдельная статья.
- В выдачу попадает не та версия. Человек приходит на адрес с меткой отслеживания или на версию для печати, где нет половины блоков и формы заявки.
Не всякий найденный дубль нужно закрывать. Браться за чистку стоит в таких случаях:
- по целевому запросу поиск показывает не тот адрес, который вы продвигаете;
- копий сотни, и на их фоне свежие материалы неделями не попадают в индекс;
- на копию ведут внешние ссылки, то есть чужой сигнал уходит мимо основной версии.
Оставить как есть можно, когда поиск уже выбрал правильный адрес: копия из выдачи исчезла, показов у нее нет. Или когда копий единицы на сайт в полторы сотни страниц и они не собирают ни показов, ни ссылок.
Порядок величин видно на условном расчете. Допустим, в индексе сайта 4 000 адресов, из них 3 000 - варианты одних и тех же карточек с параметрами фильтров. Большая часть обхода уходит на пересчет того, что робот уже видел. Новый раздел ждет обхода неделями. На сайте в сорок страниц та же доля копий ничего не значит: робот обходит его целиком за один визит.
На молодом сайте чистка дублей редко попадает в первую пятерку задач. Выше в очереди - коды ответов, попадание важных страниц в индекс и работа конверсионных блоков. Дубли ощутимы там, где адресов много: каталог с фильтрами, большой блог.
Еще одно заблуждение. За то, что ваша же страница открывается по двум адресам, поиск не понижает сайт. Он склеивает адреса и выбирает один. Санкции - другая история: массово скопированный чужой контент. К слешу в конце адреса они отношения не имеют.
Чем технические дубли отличаются от смысловых?
Технический дубль открывает один материал по нескольким адресам, текст совпадает до символа. У смыслового дубля адреса и тексты разные, а запрос за ними один: например, две статьи блога про одно и то же. Технический закрывается инструментом за десять минут, смысловой требует структурного решения: объединить страницы или переписать их под разные запросы.
Технический дубль. Один и тот же материал открывается по нескольким адресам. Текст, заголовок и картинки совпадают до символа, разница только в адресной строке. Такой случай закрывается инструментом за десять минут.
Смысловой дубль. Адреса разные, тексты тоже разные, а запрос за ними стоит один. Две статьи блога про одно и то же с разных сторон. Три посадочные страницы под медицинский педикюр, лечебный педикюр и педикюр у подолога - для человека это одна услуга и один запрос. Или страницы под соседние районы одного города: меняется только название.
Канонический адрес, инструмент против технических копий, здесь не спасает: поставленный с одной статьи на другую, он ничего не даст - содержимое разное, копией поиск такую пару не считает. Работает только структурное решение: объединить страницы или переписать под разные запросы.
Откуда берутся технические дубли?
Технические дубли берутся из шести источников: слеш в конце адреса, домен с www и без, параметры в адресе, метки отслеживания, пагинация и служебные адреса. Действий требуют не все. Параметры, метки и служебные адреса разбираются почти на каждом аудите, а по объему тяжелее всего параметры фильтров в каталоге.
- Слеш в конце адреса. Тот же материал доступен со слешем в конце и без него. Встречается почти везде, опасность низкая: поиск такие пары склеивает сам, если на сайте проставлен канонический адрес.
- Домен с www и без. Для поиска это два разных сайта. Решается на уровне настроек домена: одна версия основная, вторая перебрасывается на нее редиректом.
- Параметры в адресе. Сортировки, фильтры, идентификаторы сессий. Каталог из двухсот товаров при трех фильтрах порождает тысячи адресов с одинаковым набором карточек, и по объему это самый тяжелый источник из шести.
- Метки отслеживания. Адрес с меткой рекламной кампании технически отличается от чистого. В индекс такие адреса попадают, когда на них ведут внешние ссылки: партнер поставил ссылку с меткой, робот прошел по ней и записал новый адрес.
- Пагинация. Вторая и третья страницы списка - не копии первой, там другие карточки. Проблема возникает из-за метатегов и вводного текста, которые повторяются на всех страницах списка. Ставить на такие страницы канонический адрес первой нельзя: поиск рекомендацию отбросит, потому что содержимое отличается. Рабочий вариант - оставить пагинацию в индексе, но убрать с нее вводный текст и добавить номер в заголовок.
- Служебные адреса. Версия для печати, страница результатов внутреннего поиска, черновики, технический поддомен конструктора, оставшийся открытым после подключения своего домена.
Действий требуют не все шесть. Параметры, метки и служебные адреса разбираются почти на каждом аудите. Слеш и www на нормально настроенном сайте закрыты по умолчанию, а пагинацию трогают только тогда, когда она конкурирует с разделом за целевой запрос. Заодно проверьте карту сайта: в нее нередко попадают те самые адреса с параметрами, и тогда сайт сам приглашает робота их обойти.
Каким инструментом закрывать дубли страниц?
Дубли закрывают тремя инструментами. Канонический адрес сводит сигналы на основную версию, но остается рекомендацией. Постоянный редирект убирает второй адрес и переносит сигналы на основной. Запрет индексации метатегом убирает страницу из выдачи вместе с накопленными сигналами. Robots.txt для дублей не подходит: робот не увидит на закрытой странице ни канонического адреса, ни запрета индексации.
Канонический адрес. Тег в коде страницы, который сообщает: основная версия вот эта. Обе страницы продолжают открываться, сигналы сходятся на указанную. Но это рекомендация. Поиск вправе решить иначе, и если содержимое двух адресов заметно расходится, он так и сделает.
Постоянный редирект. Второй адрес перестает открываться, человека и робота перебрасывает на основной. Накопленные сигналы переходят туда же. Механику, коды ответов и цепочки разбираем отдельно, в статье про 301 и 302 редиректы.
Запрет индексации метатегом (noindex). Адрес остается доступным для людей, из выдачи его убирают. Сигналы при этом никуда не переходят: страница выпадает из индекса вместе со всем, что накопила.
| Ситуация | Инструмент | Что с сигналами | Что видит человек |
|---|---|---|---|
| Один материал по двум адресам, оба нужны людям | Канонический адрес | Сходятся на основную версию | Открываются оба адреса |
| Старый адрес больше не нужен | Постоянный редирект | Переходят на новый адрес | Перебрасывает на новую версию |
| Адреса с метками и параметрами | Канонический адрес на чистую версию | Сходятся на чистый адрес | Адрес с меткой открывается как обычно |
| Версия для печати, результаты внутреннего поиска | Запрет индексации метатегом | Никуда не переходят | Страница работает по-прежнему |
| Две страницы под один запрос, тексты разные | Объединение или развод по запросам | Собираются на одну после объединения | Остается одна страница или две с разными темами |
Почему robots.txt не решает проблему дублей
Самая частая ошибка выглядит так: в отчете нашлись адреса с параметрами, их закрыли в robots.txt, через месяц они по-прежнему в выдаче.
Файл управляет обходом: говорит роботу, куда не ходить. Дальше полномочия заканчиваются. Адрес, о котором поиск уже знает, останется в индексе и покажется в выдаче без описания, с пометкой о недоступном содержимом. Хуже другое: робот не заходит на закрытую страницу, а значит, не видит ни канонического адреса, ни запрета индексации, которые вы туда поставили. Запрет обхода отменяет оба инструмента. Директивы и порядок их применения собраны в разборе настройки robots.txt.
Google и Яндекс закрывают параметры по-разному
Для адресов с параметрами у Яндекса есть отдельная директива, которая склеивает такие адреса с чистым. Google закрыл свой инструмент управления параметрами и опирается на канонический адрес.
Если сайт продвигается в обеих системах, канонический адрес ставят всегда. Директиву для Яндекса добавляют сверху как уточнение. Обратный порядок не работает: убрав канонический адрес, вы оставите Google без указаний.
Что делать, когда две страницы конкурируют за один запрос?
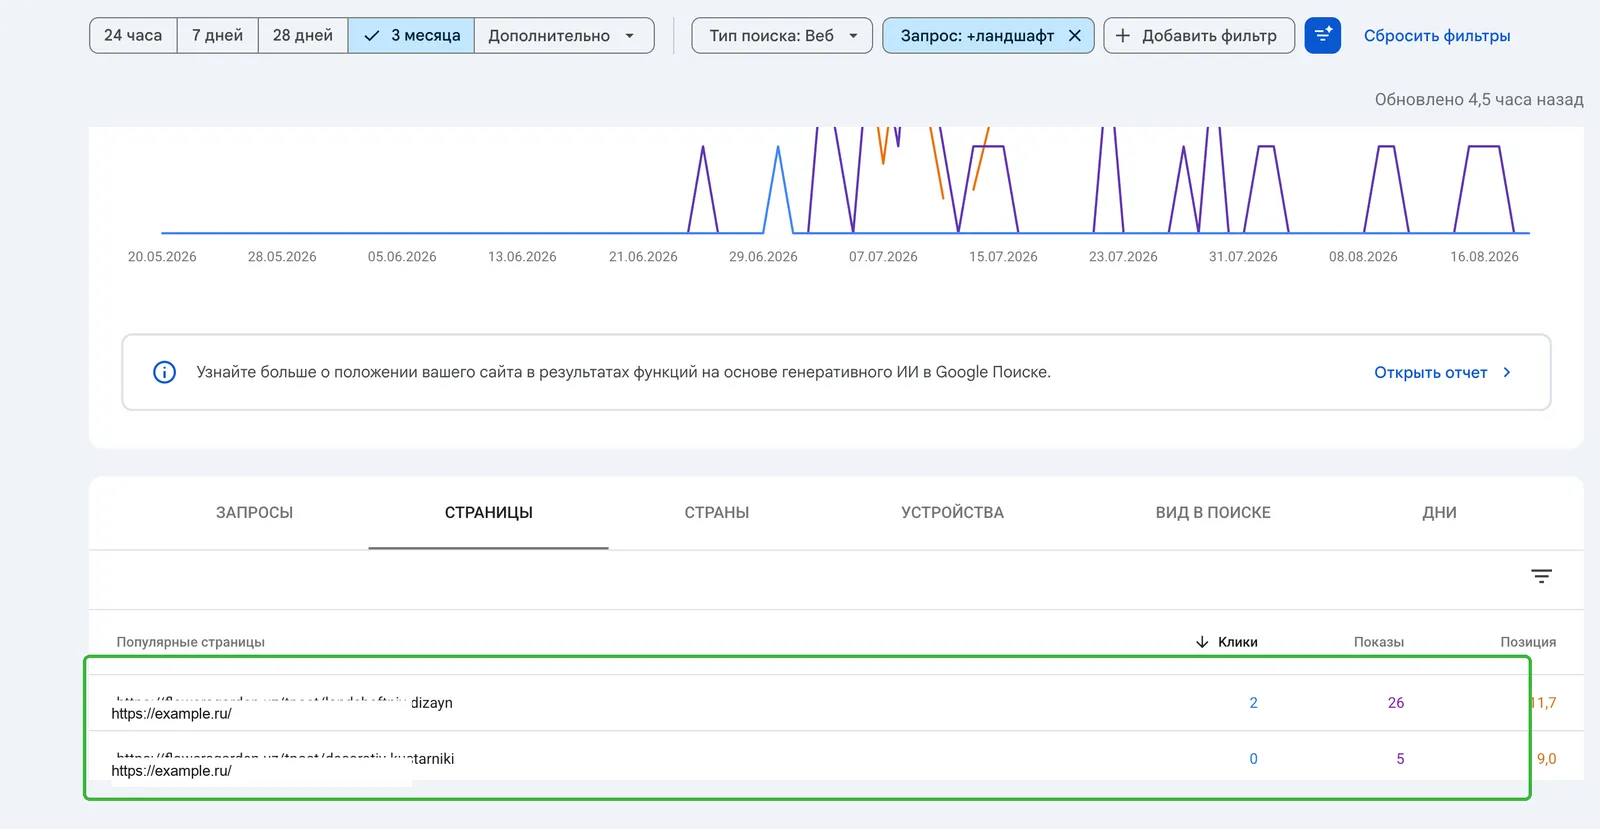
Смысловые дубли выдает выдача: по одному запросу показывается то одна ваша страница, то другая, позиции скачут, ни одна не растет. Проверяют это в Google Search Console фильтром по запросу с разбивкой по страницам. Дальше страницы объединяют, разводят по запросам или оставляют обе и назначают основную каноническим адресом.
По одному запросу в выдаче показывается то одна ваша страница, то другая. Позиции скачут в диапазоне со второй по четвертую десятку, ни одна из страниц не растет. Обе набирают показы, обе собирают мало кликов. Для блога, который писался статья за статьей без общей карты тем, это типичная картина.
Проверьте это в Google Search Console, в отчете «Эффективность» (Performance). Фильтр по запросу, разбивка по страницам - и видно, сколько своих адресов показывается по одной фразе. Механику среза разбираем в статье про отчеты Search Console.
Объединить. Вариант для двух слабых статей, которые содержательно пересекаются наполовину. Лучший материал переносят на одну страницу, вторую закрывают постоянным редиректом. Так поступают с парами вроде «изготовление коробок» и «изготовление картонных коробок»: спрос один, страниц две.
Развести по запросам. Работает, когда за страницами стоят разные намерения, а заголовки написаны так, что поиск этого не видит. Переписывают заголовок, описание и первый экран, сужают тему каждой страницы. Если тема одной «выкуп авто», у соседней в заголовке должно стоять «выкуп битых авто», а не то же самое слово в слово.
Оставить обе и назначить основную. Бывает, что страницы почти совпадают, а нужны обе: например, две версии услуги под разные города с одинаковым описанием. Основную назначают каноническим адресом. Но только при близких текстах: при разном содержимом поиск такую склейку не примет.
Пример из этого блога. Здесь уже есть статья о цене GEO-продвижения, а на очереди - статья о цене SEO-продвижения. Запросы за ними разные, но заголовки легко написать так, что поиск увидит одну тему и начнет выбирать между двумя страницами сам. Поэтому углы развели до написания: у первой - оплата за видимость в ответах нейросетей, у второй - модели оплаты классического продвижения: за позиции, за трафик, за лиды. Поправить угол до выхода статьи проще, чем сводить две страницы в одну через полгода.
Смысловые дубли не появляются на сайтах, где перед написанием собрали семантическое ядро и разложили запросы по страницам. Одно намерение - одна страница. На блогах, которые ведут без карты тем, это условие нарушается первым.
Как найти дубли страниц на своем сайте?
Дубли ищут тремя способами: оператором site: в поисковой строке Google, по отчетам вебмастера и сканером сайта. Оператор занимает минуту и не требует доступов. Отчет об индексировании в Google Search Console показывает, сколько адресов поиск признал копиями. Сканер имеет смысл от сотни адресов: он сравнивает тексты и находит то, чего нет в индексе.
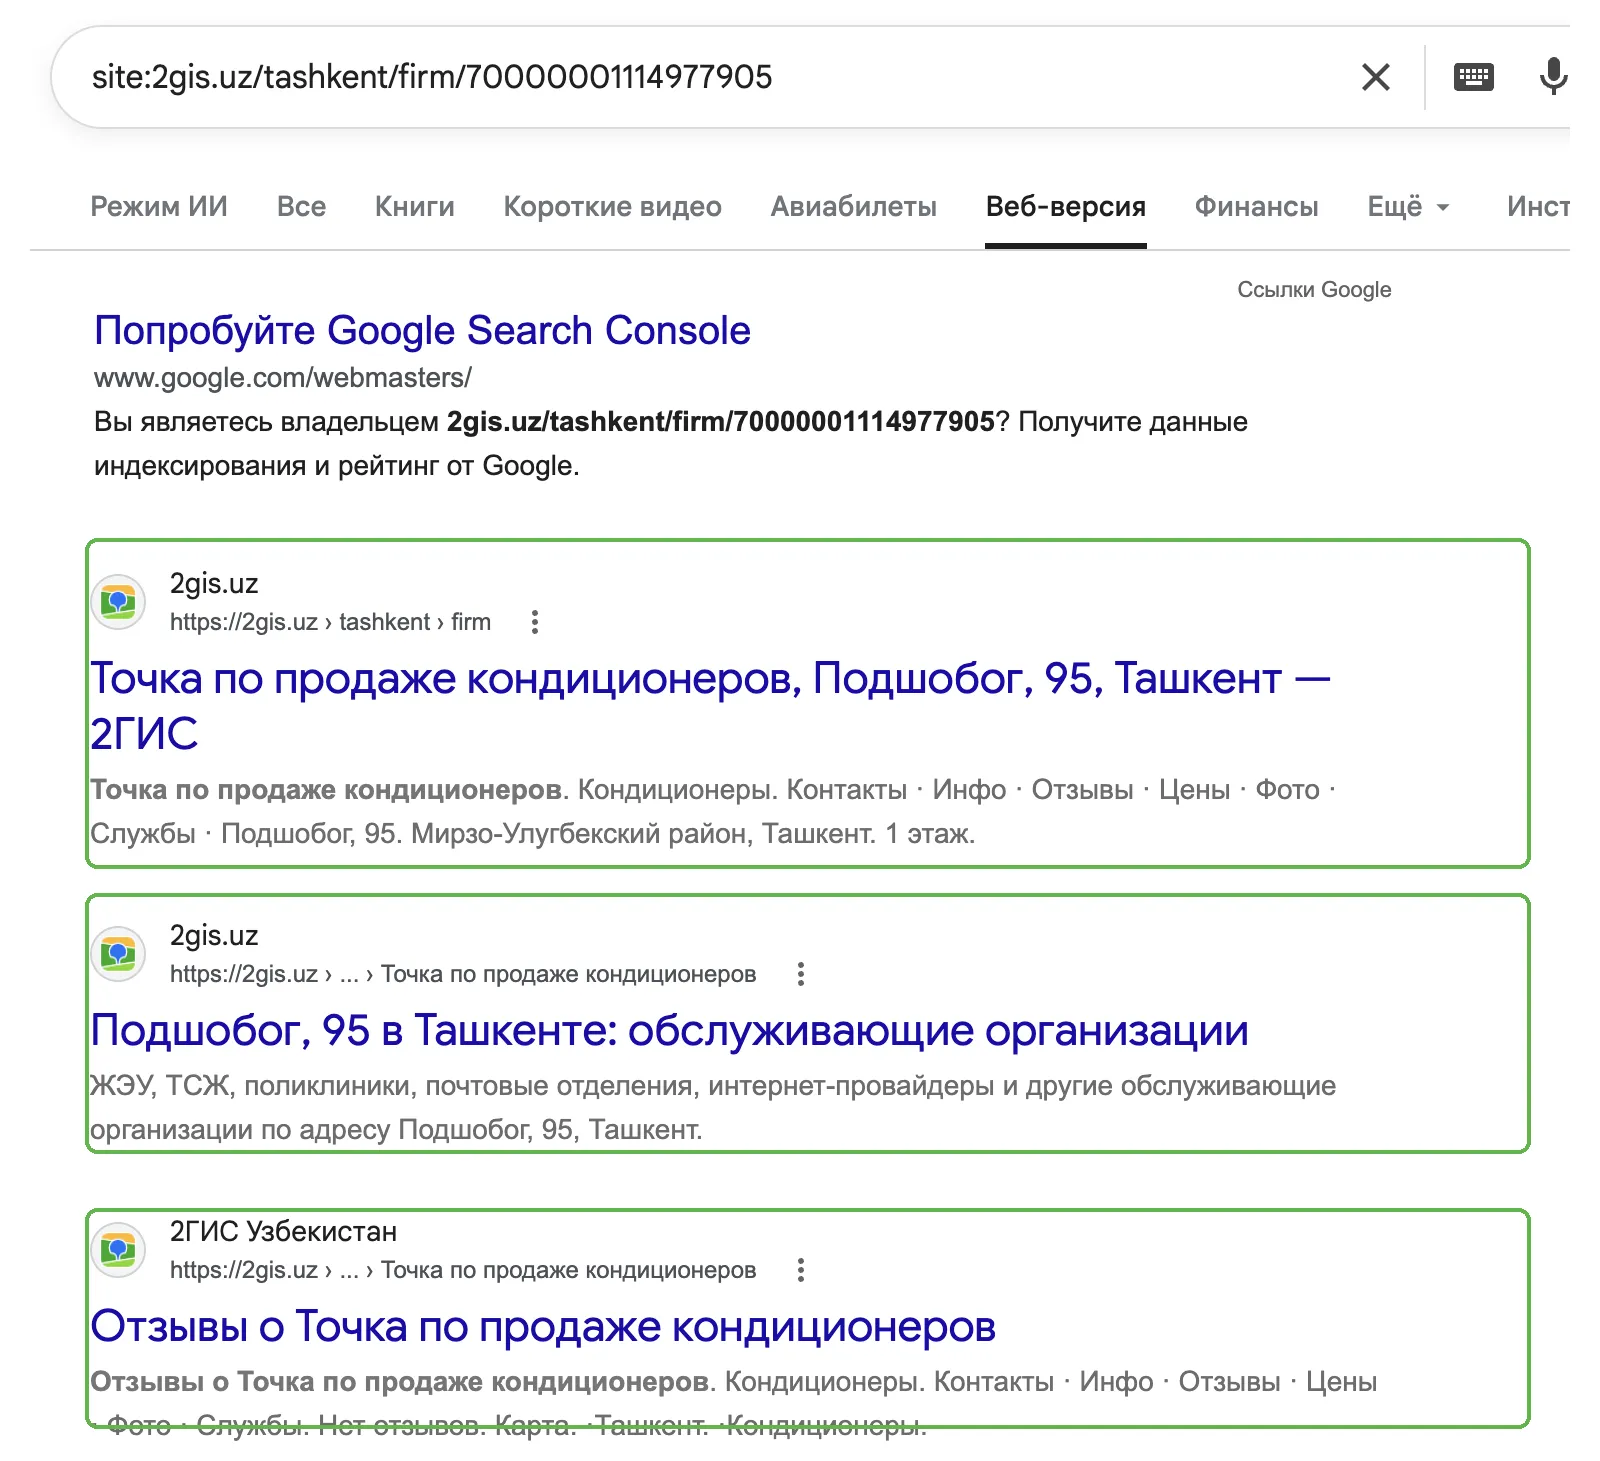
Поиск по сайту оператором. В поисковой строке Google запрос вида site:вашдомен.com показывает, что попало в индекс. Пролистайте выдачу: одинаковые заголовки подряд, адреса с параметрами и вопросительными знаками, забытые технические поддомены. Способ грубый, зато занимает минуту и не требует доступов.
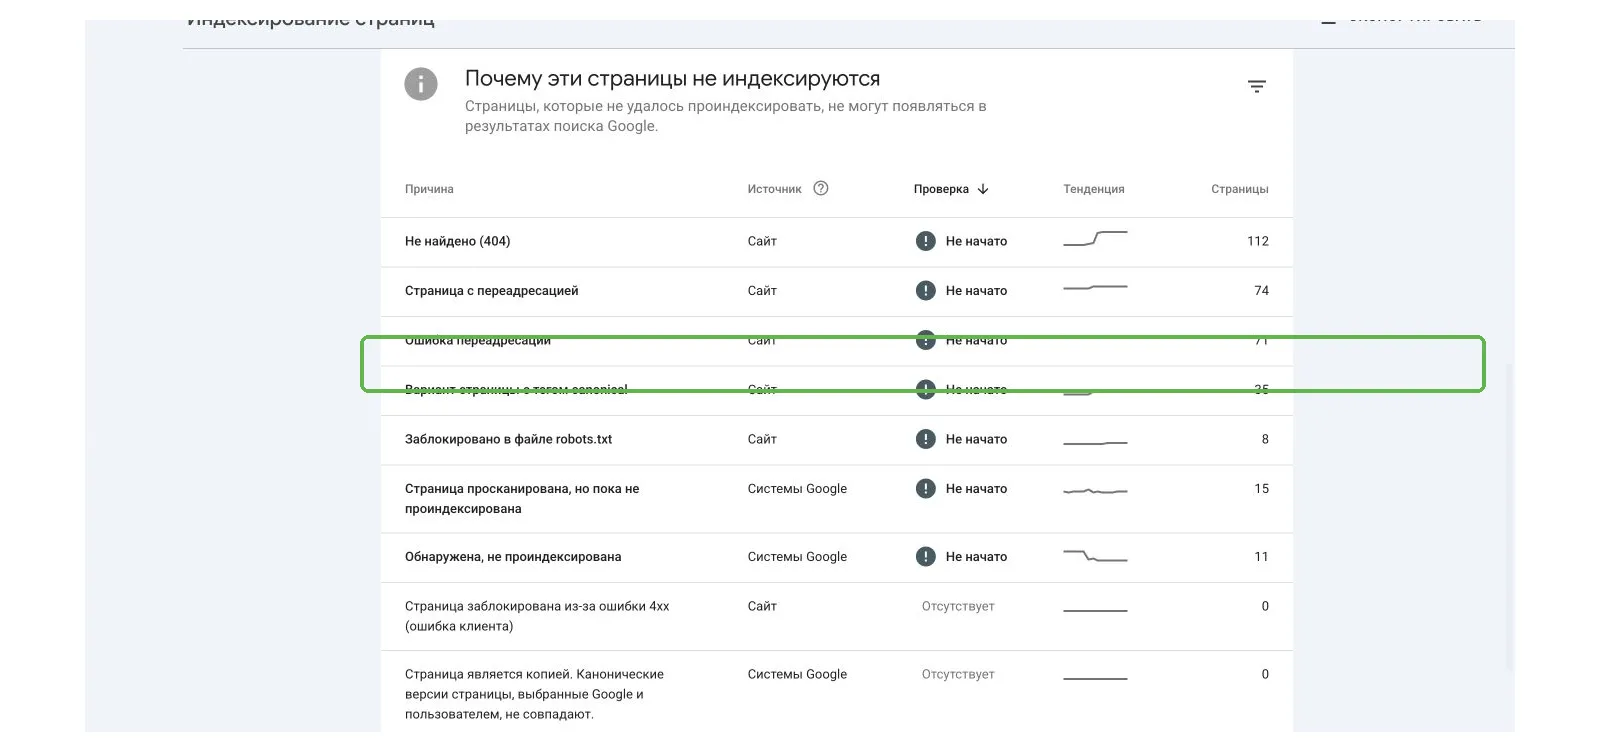
Отчеты вебмастера. В отчете об индексировании страниц (Page indexing) в Google Search Console есть статус про копию, для которой поиск выбрал другой канонический адрес. По нему видно, сколько адресов система признала дублями и какую версию оставила. В Яндекс Вебмастере то же самое лежит в разделе со страницами в поиске, среди исключенных. Можно найти конкурирующие страницы по выгрузке GSC.
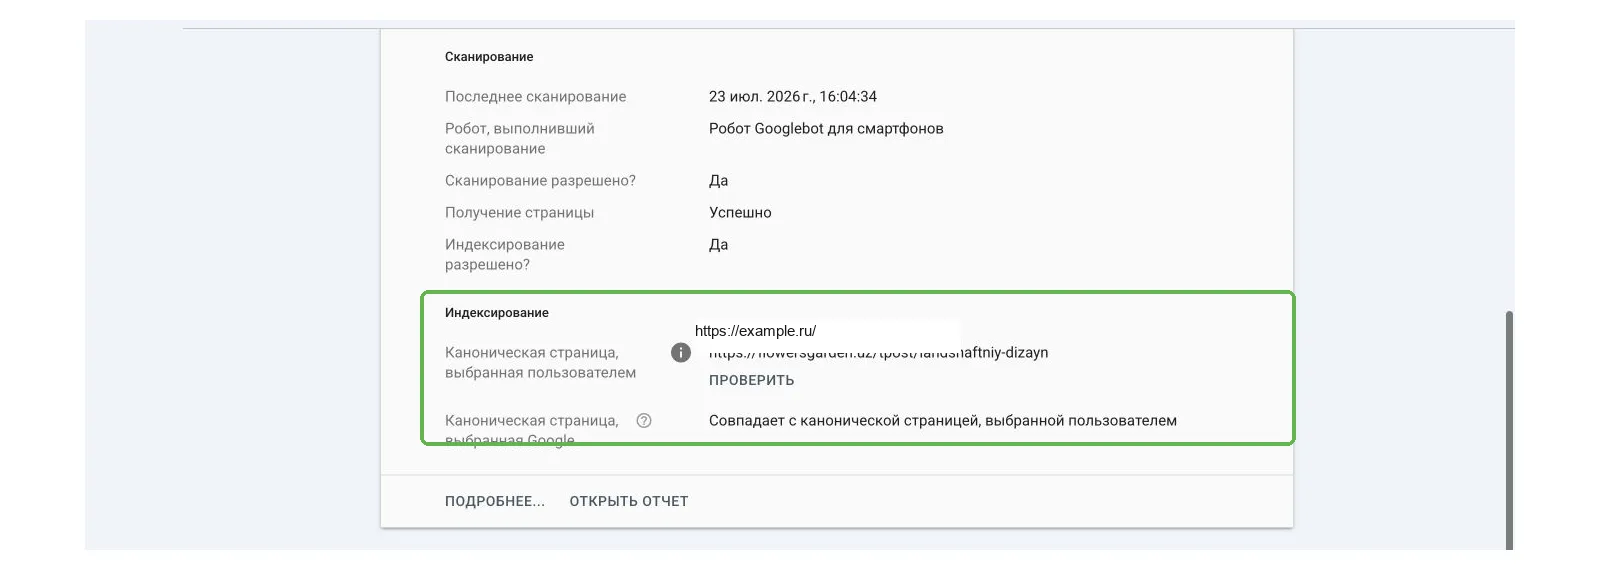
Отдельный адрес смотрят в проверке URL (URL Inspection): там видно, какой канонический адрес указали вы и какой выбрал поиск. Расхождение - сигнал, что рекомендацию не приняли: сравните содержимое двух версий.
Сканер сайта. Имеет смысл от сотни адресов. Программа обходит сайт как робот и показывает совпадающие заголовки, описания и хеши содержимого. Дубли она ищет не по названию файла, а по совпадению текста, поэтому находит и то, чего нет в индексе.
Тот же список соберет собственный скрипт: он обходит адреса из карты сайта, снимает заголовки и первые абзацы, сравнивает их между собой. На сайте в несколько тысяч адресов такой обход дает перечень пар с дословным совпадением и не упирается в лимиты бесплатных версий программ.
Проверка на дубли входит в базовый технический аудит вместе с кодами ответов и картой сайта.
Дубли в конструкторах сайтов
С конструкторами ситуация другая: часть адресов они создают сами, а доступа к коду страницы у вас нет.
На Тильде канонический адрес проставляется автоматически на каждой странице, поэтому пары со слешем и без, а также вариант с www закрыты по умолчанию.
Технический поддомен вида имяпроекта.tilda.ws после подключения своего домена никуда не девается. Если редиректы в настройках сайта не включены, копия сайта индексируется параллельно с основной версией.
Поле для канонического адреса в настройках страницы заполняется вручную. Типовая авария: страницу копируют вместе с этим полем, забывают его поправить, и новая страница сообщает поиску, что она копия старой. В индекс она не попадает, а причину ищут в robots.txt.
С чего начать чистку дублей?
Чистку начинают с выдачи оператором и отчета об индексировании: какие адреса поиск уже считает копиями и какую версию выбрал. Если его выбор совпал с вашим, делать ничего не нужно. Остальное делят на технические дубли, которые закрывают каноническим адресом, редиректом или метатегом, и смысловые, которые требуют работы по содержанию.
- Посмотреть выдачу оператором и отчет об индексировании. Понять, какие адреса поиск уже считает копиями и какую версию он выбрал.
- Сверить выбор поиска со своим. Совпал - вопрос закрыт, можно ничего не делать.
- Разделить найденное на технические и смысловые дубли.
- Технические закрыть по таблице выше: канонический адрес, редирект или метатег. Только не через robots.txt.
- Смысловые вынести в отдельную задачу: объединить, развести или оставить одну. Это работа по содержанию, и за десять минут она не делается.
Частые вопросы
Сколько дублей считается проблемой?
Считать штуки бессмысленно, важны доля и последствия. Десяток служебных адресов на сайте в пятьсот страниц не влияет ни на что. Половина индекса из адресов с параметрами - повод разбираться сегодня. Ориентир: свежие материалы попадают в индекс медленно, а по целевым запросам показывается не та страница.
Чем канонический адрес отличается от запрета индексации?
У канонического адреса задача свести сигналы двух адресов на один: обе страницы открываются, а накопленный вес достается основной. Запрет индексации метатегом убирает страницу из выдачи целиком, и ее сигналы не переходят никуда. Первый вариант - для копий, которые нужны людям. Второй - для служебных адресов, которым в поиске делать нечего.
Правда ли, что за дубли понижают в выдаче?
За технические дубли - нет: поиск склеивает адреса и показывает один. Поверье осталось с тех времен, когда поисковые системы хуже распознавали копии и держали в индексе обе версии. Если позиции упали, а в отчетах видны дубли, сначала посмотрите, что еще менялось на сайте в те же недели.
Главная страница открывается со слешем и без - это надо чинить?
Сначала проверьте, что видит поиск. Если в проверке URL стоит одна версия и она же показывается в выдаче, ситуация под контролем. Чинить нужно, когда обе версии индексируются и на обе ведут внешние ссылки: тогда одну назначают основной, вторую перебрасывают редиректом.
Пагинация - это дубли?
Строго говоря, нет: карточки на второй и третьей странице другие. Похожими эти страницы делают одинаковые метатеги и вводный текст, который тянется через весь список. Канонический адрес первой страницы на остальные ставить не нужно, поиск его отбросит. Хватает номера страницы в заголовке и вводного текста только на первой.
Чем проверить дубли бесплатно?
Бесплатно дубли закрываются тремя инструментами: оператор site: в выдаче, отчет об индексировании в Google Search Console и раздел со страницами в поиске в Яндекс Вебмастере. Для сайтов до пятисот адресов к ним добавляется настольный сканер - у него есть бесплатная версия. Онлайн-сервисы, обещающие поиск дублей по одной кнопке, показывают то же самое, что и отчеты вебмастера, но без исторических данных.