Customer Match: как загрузить базу клиентов в Google Ads

Через Customer Match рекламу видят люди, чьи контакты у вас уже есть: телефон, электронная почта или почтовый адрес. Доступ к инструменту дают не всем аккаунтам. База грузится в хешированном виде, а поля приводят к формату Google заранее, иначе доля совпадений упадет почти до нуля. Пороги минимального размера списка отличаются в зависимости от типа кампании и площадки. Совпадение ниже половины загруженных контактов - повод чистить базу.
Customer Match - механика, через которую собственная база контактов превращается в аудиторию Google Ads. Вы отдаете системе email и телефоны, Google сопоставляет их со своими аккаунтами, из совпадений собирается сегмент для таргетинга, исключения или корректировок ставок. Ниже: кому доступ открыт, а кому нет, как готовится файл и что происходит с данными при хешировании, какие пороги размера работают в 2026 году, почему база из тысячи строк дает аудиторию меньше тысячи и в каких сценариях списки клиентов дают результат, которого не дает поведенческий ремаркетинг.
Что такое Customer Match и где он работает
Customer Match - способ показать рекламу людям, чьи контакты у вас уже есть. Схема работы короткая: вы загружаете файл с email, телефонами или почтовыми адресами, Google сопоставляет эти данные с аккаунтами своих пользователей и собирает из совпавших людей сегмент. Дальше сегмент работает как обычная аудитория: на него настраивают таргетинг, его исключают, под него правят ставки.
В русской локализации интерфейса это называется «список клиентов». В справке и в разговорах агентств чаще звучит английское Customer Match, поэтому в статье дальше идут оба названия.
Списки клиентов работают на всех основных площадках Google: в поиске, на вкладке «Покупки», в Gmail, на YouTube и в контекстно-медийной сети. В Performance Max база подключается сигналом аудитории, в Demand Gen - основой для похожих сегментов.
Чем список клиентов отличается от ремаркетинга
Разница в источнике аудитории. Ремаркетинг собирает людей по действиям: зашел на сайт, посмотрел товар, досмотрел ролик до конца. Аудитория набирается сама, ваше участие сводится к тегу и правилам сегмента.
Список клиентов вы приносите. Никакого поведения на сайте у этих людей может и не быть: клиент пришел через офлайн-точку, оставил телефон менеджеру или оформил заказ пять лет назад, когда счетчиков еще не стояло. Для бизнеса с длинной историей и CRM это часто аудитория, которую больше нечем достать.
Второе отличие практическое. Ремаркетинговый сегмент привязан к устройству и браузеру, из которых человек заходил. Сопоставление по email работает через аккаунт Google, поэтому один и тот же человек находится и на телефоне, и на рабочем ноутбуке, и в приложении YouTube на телевизоре.
Списки клиентов на основе конверсий
Отдельная разновидность, которая собирается без файлов. Если в настройках аккаунта включить сбор списков клиентов на основе конверсий, Google начнет складывать сконвертившихся пользователей в отдельные сегменты по каждой цели конверсии. Данные туда попадают из тех, что человек оставил на сайте, в хешированном виде, и сегмент обновляется по мере поступления новых конверсий.
Такой список удобен как черновая замена загрузке: настраивается галочкой, обновляется без вашего участия, годится для исключений и для сигналов. Но контроля над ним нет - вы не решаете, кто туда попадет и по каким признакам. Сегментировать базу по среднему чеку, давности покупки или продукту получится только через свою выгрузку.
Что происходит со списками автоматически
Тут есть момент, который меняет отношение к загрузке базы. Кампании со Smart Bidding и оптимизированным таргетингом подтягивают все списки клиентов аккаунта в работу сами - как дополнительный сигнал для алгоритма, без вашего подключения к конкретной кампании.
Из этого следует пара выводов. Первый: загруженная база начинает влиять на аукцион шире, чем на одну кампанию, куда вы ее прицепили. Второй: мусор в базе тоже уходит в сигнал. Файл, куда свалили всех подряд без разбора, учит алгоритм неверному представлению о ценном клиенте.
Требования к аккаунту: доступ есть не у всех
Customer Match закрыт за порогом допуска, и это первое, что стоит проверить перед разговором с клиентом о выгрузке базы.
Базовое условие - чистая история соблюдения рекламных правил. Аккаунт с блокировками и повторными нарушениями до механики не допускают вообще.
Дальше объем доступных возможностей зависит от истории аккаунта:
- Любой аккаунт без нарушений - списки клиентов доступны в режиме наблюдения и для исключений. Таргетироваться на базу нельзя, исключить ее из показов и посмотреть статистику по сегменту - можно.
- Аккаунт с историей от 90 дней и суммарными расходами больше $50 000 за все время - открывается таргетинг, ручные корректировки ставок и похожие сегменты, построенные от базы.
Порог в $50 000 считается по всей истории аккаунта, а не за период. Малый бизнес, который тратит $600 в месяц, доберется до таргетинга через несколько лет. Обходной путь - работа через управляющий аккаунт агентства, у которого история и расходы уже набраны: требования проверяются и на уровне управляющего аккаунта тоже.
Отдельная категория ограничений - чувствительные тематики. Медицина, финансовые трудности, темы, связанные с личными характеристиками человека: там персонализированная реклама урезана, и списки клиентов в этих нишах либо недоступны, либо доступны частично. Клинике или наркологическому центру эту механику предлагать бессмысленно, независимо от расходов аккаунта.
Граница проходит по одному признаку: если ниша закрыта для ремаркетинга и работы с базами, то закрыта и здесь. Все остальное - обычная реклама без ограничений по этой части. Опасений по поводу самой механики у бизнеса тоже стоит поубавить: ремаркетинг человек встречает каждый день по десятку раз, обойдя пару сайтов и посмотрев ролики на YouTube. Значение имеет содержание рекламы: что она предлагает и задевает ли личные обстоятельства человека.
Как готовится база: поля, формат, хеширование
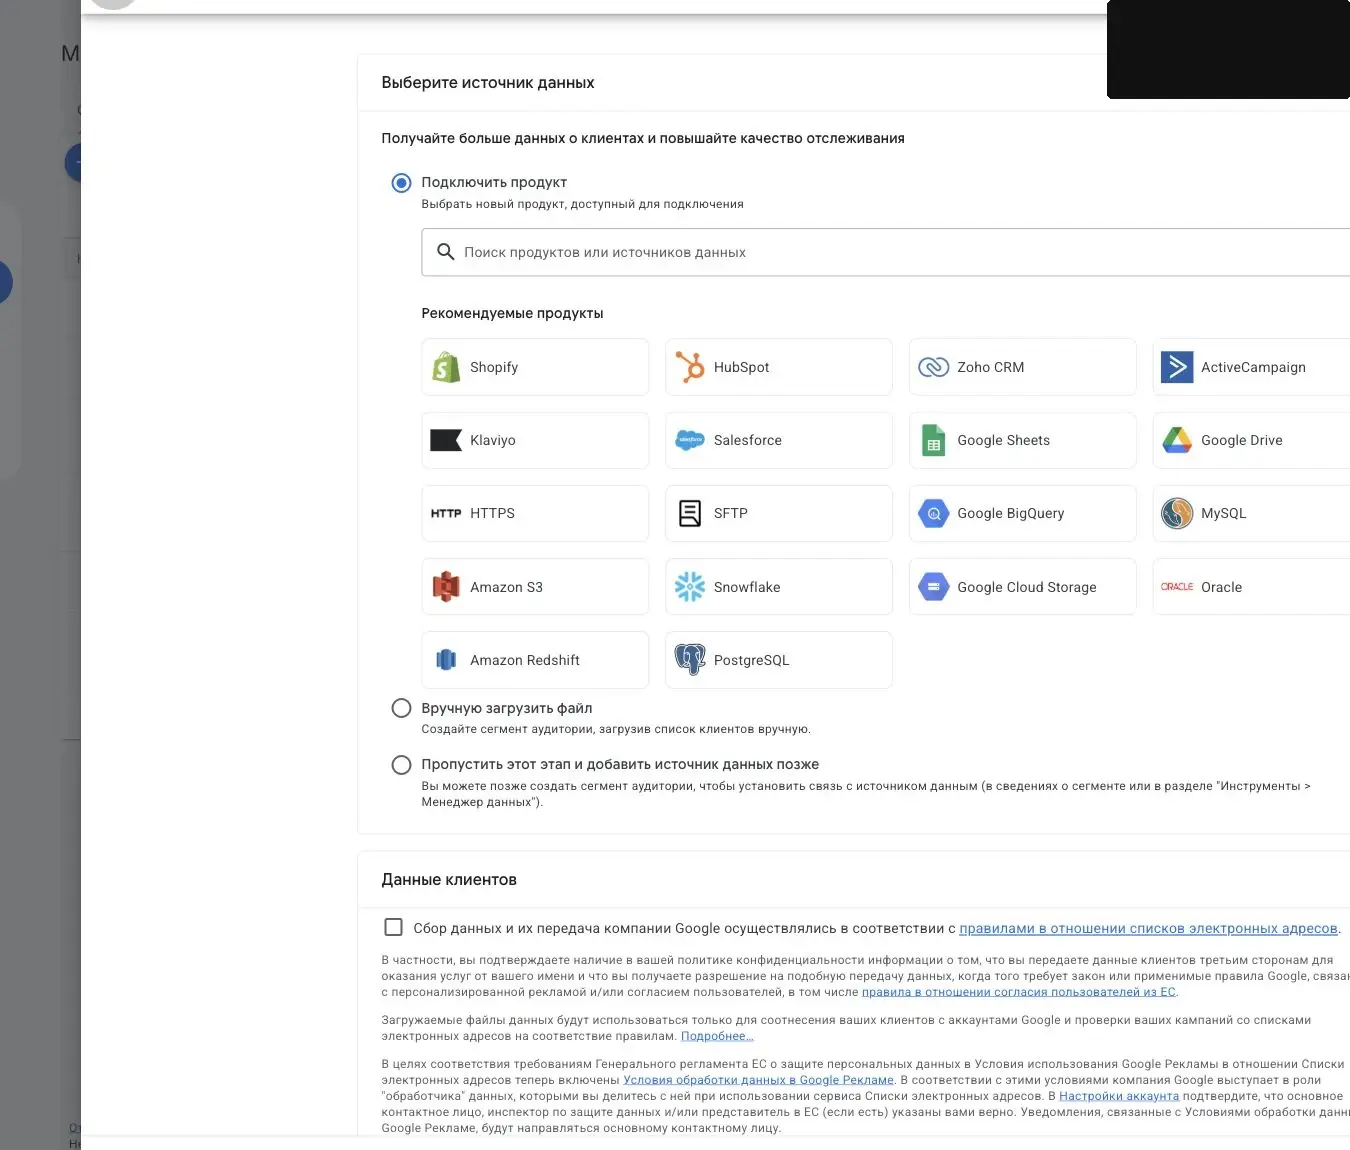
Списки клиентов создаются в менеджере аудиторий: меню «Инструменты» - «Общая библиотека» - «Менеджер аудиторий», вкладка сегментов данных. Там же лежат сегменты посетителей сайта, так что путь знаком по ремаркетингу.
Какие поля принимает Google
Идентификаторов четыре: email, номер телефона, почтовый адрес и идентификатор мобильного устройства. Обязателен хотя бы один, остальные необязательны, но каждый добавленный увеличивает шанс совпадения.
Структура файла жесткая: одна строка - один человек, колонки подписаны по требованиям Google. Для почтового адреса нужен полный набор: имя, фамилия, страна, почтовый индекс. Половина адреса не работает - если фамилии нет, строка не сопоставится.
Требования к формату значений:
- email приводятся к нижнему регистру, пробелы по краям срезаются
- телефоны идут в формате E.164: плюс, код страны, номер без пробелов, скобок и дефисов
- страна задается двухбуквенным кодом
- пустые ячейки лучше оставить пустыми, чем заполнить прочерком или словом «нет»
Аккуратность на этом шаге стоит дороже, чем кажется. Номер, записанный как 8 (777) 123-45-67, не сопоставится ни с чем - Google ждет +77771234567. Партия телефонов в казахстанском формате без плюса срежет долю совпадений сразу, и разбираться потом придется по статусу загрузки, где написано только общее число совпавших.
Что такое хеширование и зачем оно тут
Хеширование - односторонняя математическая свертка. Из email получается строка фиксированной длины, из которой исходный адрес обратно не собирается. Одинаковые входные данные всегда дают одинаковый результат, поэтому сравнивать хеши между собой можно, а прочитать их - нет.
Google использует алгоритм SHA-256. Сопоставление идет так: ваши хеши сравниваются с хешами, посчитанными от данных аккаунтов Google. Совпало - человек попал в сегмент. Не совпало - строка отбрасывается.
Хешировать можно двумя способами. При загрузке файла через интерфейс Google хеширует данные на своей стороне - от вас нужен обычный CSV. Второй вариант: вы хешируете сами до отправки, алгоритмом SHA-256 в шестнадцатеричном виде, и в Google уходит уже нечитаемый файл.
Практика с клиентами обычно проще, чем ожидается. Базу отдают охотно: бизнесу нужны клиенты дешевле, и если механика в этом помогает, вопрос снимается за одну встречу. Отказов из-за нежелания делиться данными в моих проектах не было.
Но я сам предлагаю другой порядок - пусть клиент заливает базу в кабинет напрямую, без промежуточной пересылки подрядчику. Настройку это не усложняет: я говорю, какие поля нужны и в каком формате, дальше человек со стороны клиента загружает файл сам. Контакты при этом не проходят через чужую почту и чужой ноутбук, и вопрос о добросовестности подрядчика не возникает в принципе.
Хеширование на своей стороне остается запасным вариантом для юристов, которые формулируют требования жестче. Важная деталь: нормализация делается до хеширования. Если email не привели к нижнему регистру перед сверткой, хеш получится другой, и совпадения не будет.
Сегментация базы перед загрузкой
Одна большая выгрузка «все клиенты» дает мало. Полезнее разложить базу по признакам, которые есть в CRM, и завести отдельный список под каждый:
- покупали за последние 90 дней
- покупали больше года назад и не возвращались
- оставили заявку и не купили
- верх по среднему чеку или по числу заказов
- купили конкретный продукт, к которому есть допродажа
Списки с разной логикой применяются по-разному: одни исключаются, на другие ставки повышаются, третьи идут сигналом в Performance Max. Разделить их при загрузке дешевле, чем потом резать один общий сегмент, который резать нечем.
Пороги размера и доля совпадений
Порог для запуска списка клиентов - 100 активных пользователей за последние 30 дней. Для остальных сегментов в поиске и на YouTube порог выше, тысяча, но именно для загруженных баз Google его снизил, и это заметно расширило круг тех, кому механика доступна.
Второй порог задан правилами: чтобы список оставался рабочим, в нем должно быть не меньше 100 участников, добавленных или обновленных за последние 540 дней. Записи старше полутора лет из аудитории выпадают. База, загруженная один раз и забытая, через 540 дней перестанет работать целиком.
Почему из тысячи строк получается меньше тысячи
Размер аудитории после обработки всегда меньше размера файла, и разрыв бывает большим. Причин несколько.
Часть контактов не привязана к аккаунтам Google: почта на локальном домене, корпоративный ящик без Google Workspace, телефон, который человек нигде не указывал. Сопоставлять нечего.
Часть контактов оформлена так, что до сравнения дело не доходит - те самые телефоны без кода страны и адреса с опечатками.
Часть людей неактивны. В интерфейсе показывается размер по активным пользователям за последние 30 дней, округленный. Клиент, который завел аккаунт и им не пользуется, в это число не попадет, хотя формально совпадение есть.
Наконец, размер в интерфейсе разный для разных площадок: аудитория для поиска и аудитория для YouTube считаются отдельно, и цифры не совпадают.
Ориентир по моим загрузкам в Узбекистане и Казахстане: из 10 000 контактов совпадает около 4 000. Цифра держится примерно на этом уровне не только в Google Ads - при заливке той же базы в другие рекламные системы картина похожая. Упирается все в сами данные и в то, сколько людей за ними стоит с работающими аккаунтами.
Практический вывод: базу в пятьсот строк грузить можно, но рассчитывать на самостоятельную кампанию по ней не стоит. Такой список полезнее как исключение и как сигнал для алгоритма. Для таргетинга с ощутимым объемом трафика нужны десятки тысяч контактов - тогда и доля совпадений в районе сорока процентов дает рабочую аудиторию.
Сколько ждать после загрузки
Обработка занимает время, обычно до нескольких дней. Сразу после загрузки в интерфейсе будет пусто или почти пусто, и это нормально. Делать выводы о качестве базы по цифре первого часа не стоит - и тем более не стоит перезаливать файл повторно, решив, что загрузка не прошла.
Сценарии: где список клиентов дает результат
Исключение тех, кто уже купил
Самый недооцененный сценарий, и начинать стоит с него - он доступен даже на аккаунте без истории расходов.
Логика простая по смыслу: бюджет на привлечение не должен уходить на людей, которые уже клиенты. Для подписочных сервисов, курсов, услуг с длинным циклом это прямая экономия - действующий подписчик кликает по рекламе своего же сервиса, потому что узнает бренд, и вы платите за клик, который ничего не приносит.
Механика: загружаете список покупателей, подключаете его к кампаниям на привлечение как исключение. Глубина списка подбирается под цикл покупки. Кондиционеры покупают раз в несколько лет, и исключать покупателя на 540 дней разумно. Расходники заказывают каждый месяц, там исключение вредно.
Допродажи и реактивация
Обратный ход: отдельная кампания на тех, кто уже покупал. Аудитория теплая, узнаваемость есть, конверсия обычно выше холодного трафика, а поисковый запрос при этом может быть общим.
Рабочие связки: покупателям базового продукта показывать расширение, клиентам годичной давности - повод вернуться, тем, кто оставил заявку и не дошел до оплаты, - предложение с ограничением по времени.
Здесь же уместны повышенные ставки. Если список подключен в режиме таргетинга или наблюдения, корректировка ставок настраивается отдельно - и платить за клик клиента с историей покупок выгоднее, чем за клик незнакомого человека по той же цене.
Сигнал для автоматических кампаний
В Performance Max база подключается как сигнал аудитории. Это не таргетинг: алгоритм не ограничивается вашими клиентами, он использует список как описание того, кто вам нужен, и ищет похожих. Список клиентов считается сигналом высокого качества - выше, чем набор интересов, собранный вручную.
Там же работает цель «Привлечение новых клиентов». Порядок действий: сначала база загружается в менеджер аудиторий, потом в настройках кампании задается дополнительная ценность конверсии для новых клиентов. Google опирается на список, чтобы отличить нового покупателя от существующего. Режим «показывать только новым клиентам» на старте лучше не включать: он режет объем, а до накопления статистики это опасно.
В моих проектах два применения перекрывают почти все остальные: исключение купивших и подача базы сигналом. Второе я делаю даже там, где отдельной кампании по списку не планируется, - Performance Max, который стартует с нормальной клиентской базой в сигнале, обучается быстрее, чем тот же кабинет с пустыми сигналами и одними интересами.
Похожие сегменты от базы
Похожие сегменты (lookalike) в Google Ads доступны только в кампаниях Demand Gen. В поиске, Performance Max и медийных кампаниях эта механика не работает - подключенный сегмент покажет статус ограниченного действия и результата не даст.
Исходной аудиторией берется ваш список клиентов, алгоритм ищет людей со схожим поведением. Требования к исходной базе выше, чем к обычному списку: нужно порядка тысячи совпавших активных пользователей, иначе сегмент не соберется.
С весны 2026 года Google меняет логику похожих сегментов в Demand Gen: раньше вы выбирали степень близости к исходной аудитории и алгоритм в этих границах держался, теперь база работает подсказкой, а не ограничением. Система может выйти за пределы похожести, если решит, что там есть конверсии. Для тех, кому нужен прежний контроль, предусмотрен отказ от изменения через заявку.
Комбинация с другими сигналами
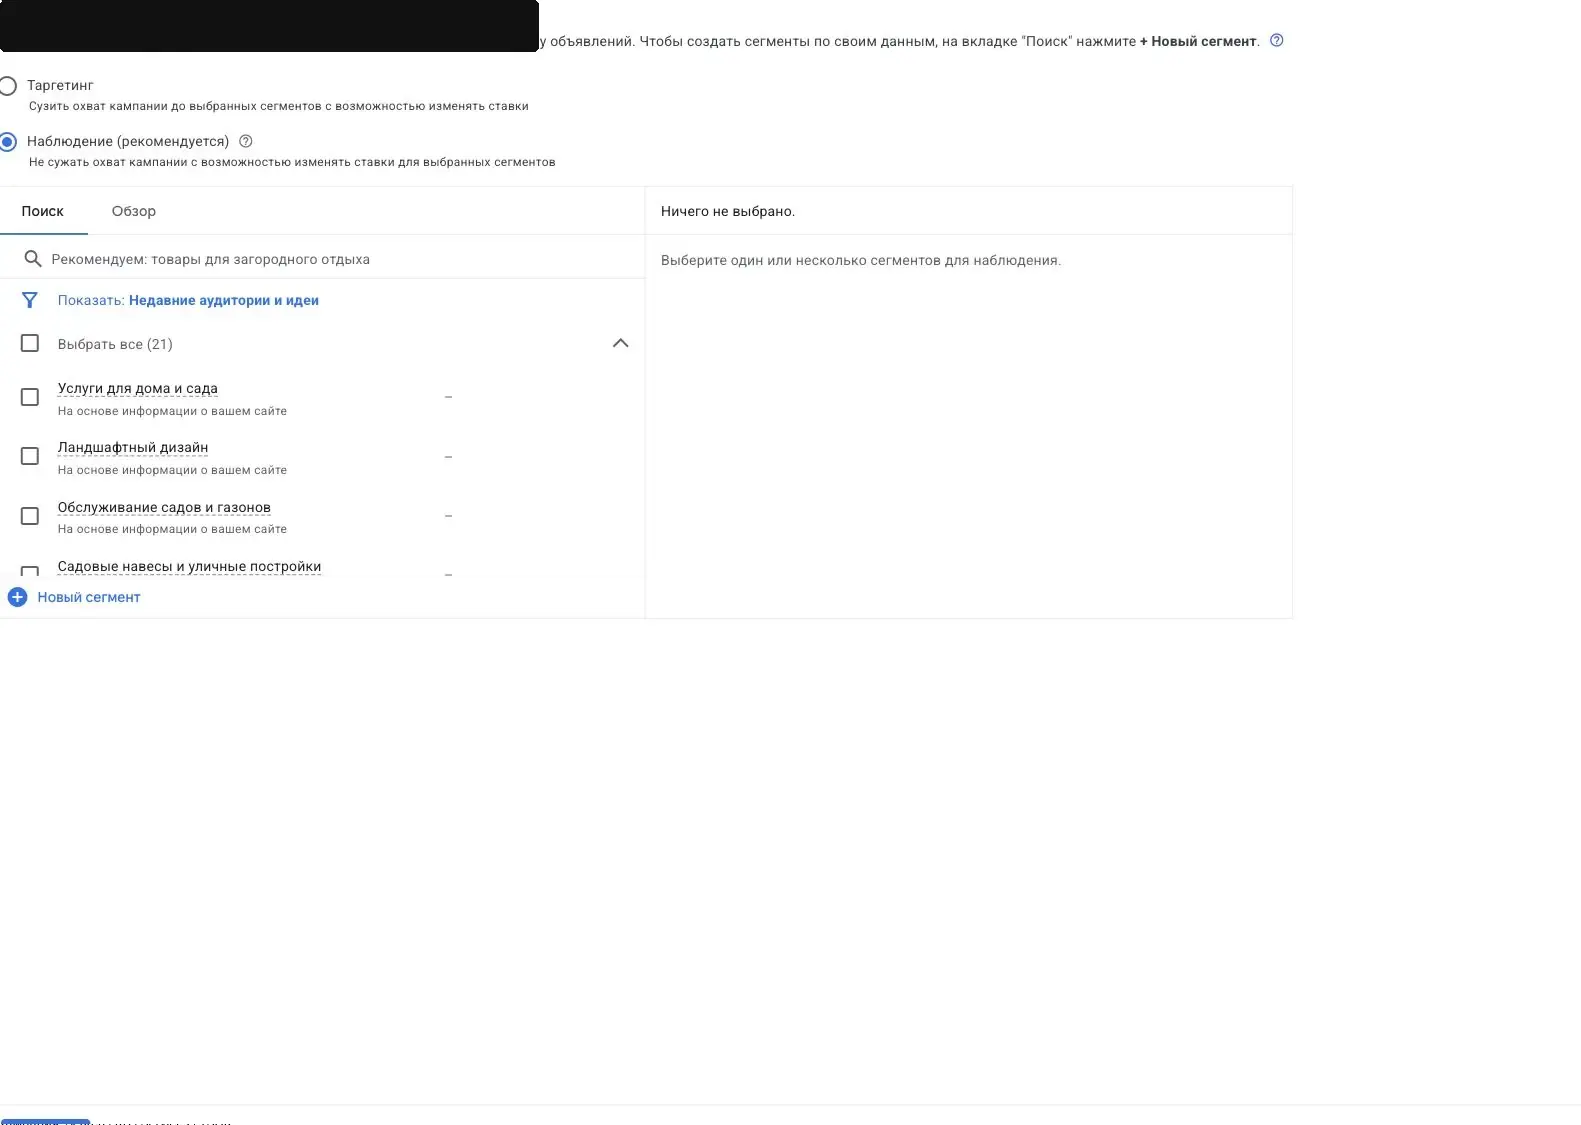
Список клиентов сочетается с остальным таргетингом. Сегмент заинтересованных покупателей плюс ваша база плюс географическое сужение дают аудиторию заметно уже каждого из условий по отдельности. В поиске к этому добавляются ключевые слова - и получается пересечение намерения и знакомства с брендом.
Правило подключения на старте одно: сначала наблюдение, потом таргетинг. Наблюдение не сужает охват, но дает статистику по сегменту. Через две-три недели видно, отличается ли поведение вашей базы от остального трафика, и решение о корректировках принимается по цифрам, а не по ожиданиям.
Загрузка и обновление списков
Три способа передать данные
Ручная загрузка файла. CSV с подписанными колонками загружается через менеджер аудиторий. Подходит для разовых задач и первого теста: выгрузили из CRM, проверили формат, загрузили. Минус очевиден - через месяц файл устарел, и никто об этом не напомнит.
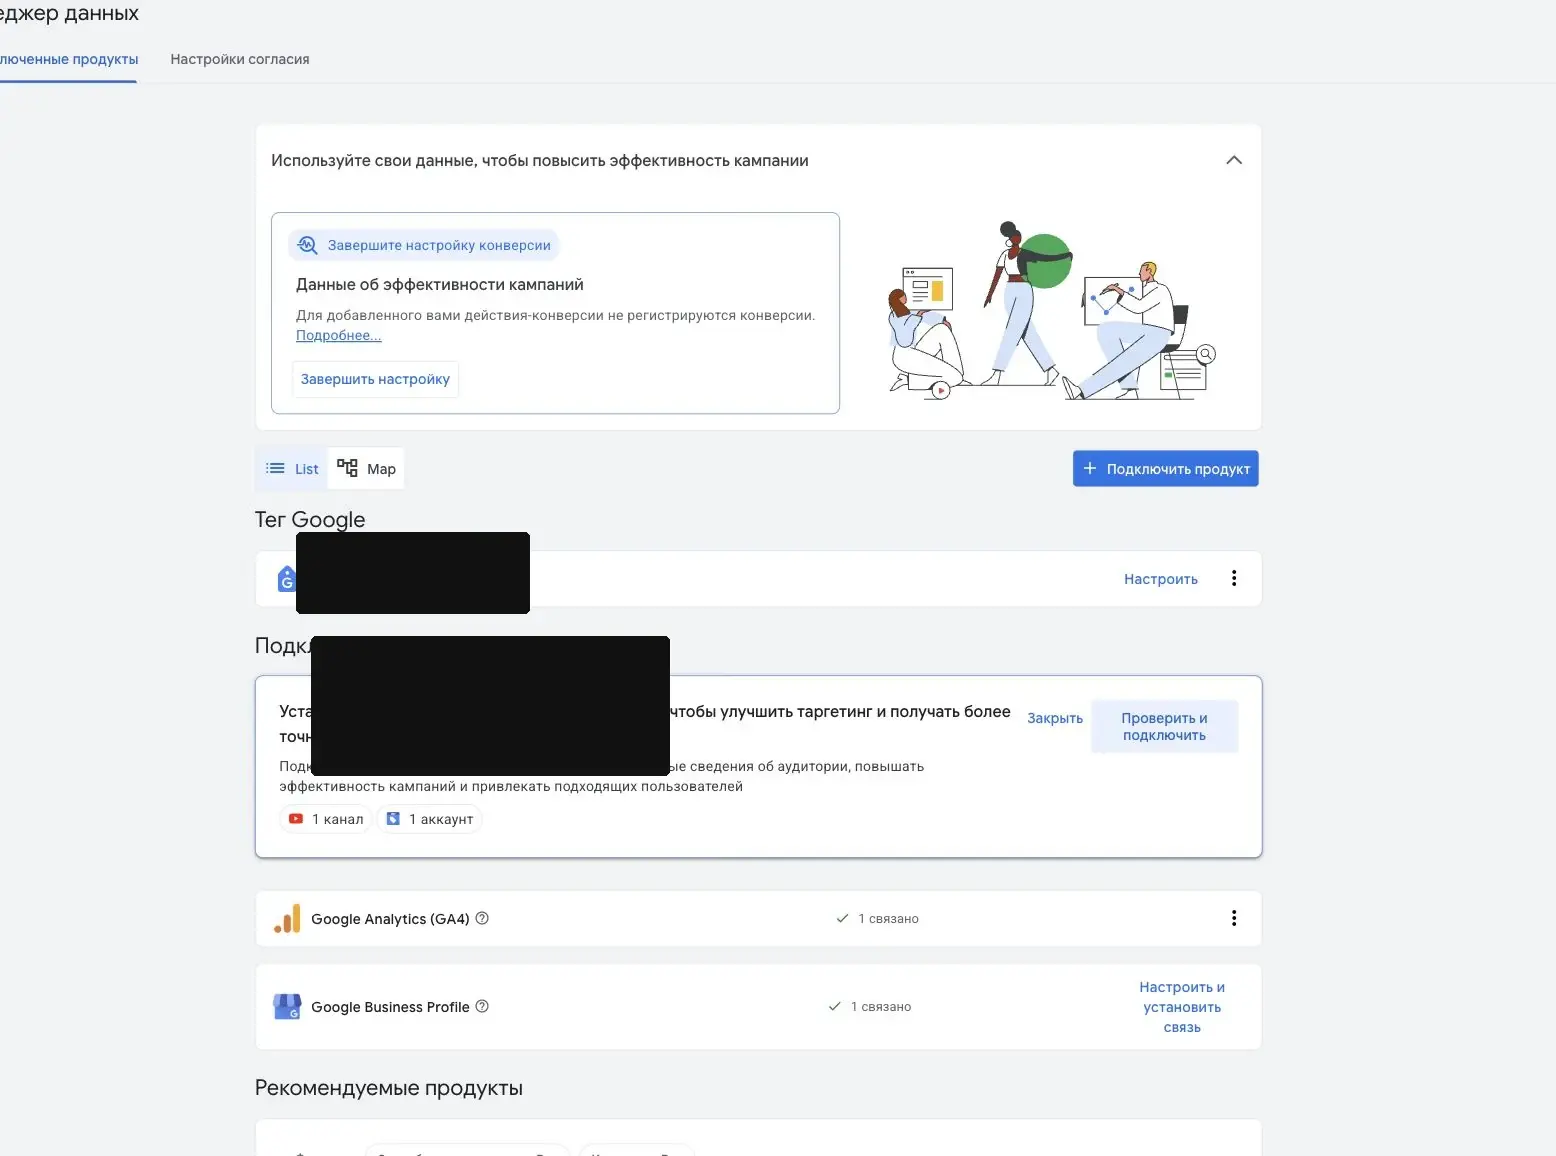
Подключение источника данных. В меню «Инструменты» появился «Менеджер данных» - туда переехали настройки связанных аккаунтов и источников. Через него подключаются CRM и платформы рассылок: HubSpot, Mailchimp, Klaviyo, Salesforce и другие сервисы с готовой интеграцией. Синхронизация идет по расписанию, база в Google Ads обновляется вместе с базой в CRM.
Программная передача. Для крупных проектов и нестандартных CRM остается API. Здесь важное изменение: с апреля 2026 года Google закрыл прием запросов Customer Match через старые методы Google Ads API для тех разработчиков, кто раньше их не использовал. Новые интеграции строятся на Data Manager API. Если подрядчик приносит схему на устаревших методах, стоит уточнить, работала ли она раньше на этом же токене.
Как часто обновлять
Устаревший список теряет качество двумя путями сразу: доля совпадений падает, потому что часть контактов уже недействительна, и сегментация врет, потому что человек из списка «не купил» полгода назад купил.
Разумный ритм зависит от того, как быстро меняется база. Для e-com с потоком заказов - еженедельная синхронизация. Для B2B с несколькими сделками в месяц хватит ежемесячной. Ручную выгрузку стоит поставить в календарь: механика тихая, о протухшей базе интерфейс не сообщает.
По моим проектам обновление держится на двух вариантах. Либо руками, если база небольшая и меняется медленно. Либо через прямую интеграцию с системой, где статус клиента уже есть, - CRM или колл-трекинг. Второй вариант ценнее тем, что в такой системе рядом с контактом лежит его история: лид, дошел до сделки, купил повторно. Списки тогда обновляются вместе со статусами, и разбираться, кого пора перенести из «оставил заявку» в «купил», не приходится вручную.
Отдельно про удаление. Список обновляется не только добавлением: людей из него нужно и убирать - тех, кто отписался, отозвал согласие или ушел из клиентов. Это делается загрузкой файла на удаление или синхронизацией, которая переносит изменения из CRM обеими сторонами.
Согласие и приватность
Тема, где ошибка стоит доступа к механике целиком. При этом на практике она закрывается на этапе сбора контактов, а не на этапе загрузки: если согласие берется в форме заказа и фиксируется в CRM, к моменту разговора о рекламе вопрос уже решен.
Что требует Google
Правило формулируется коротко: загружать можно только те контакты, владельцы которых дали согласие на использование данных в рекламных целях. Не согласие на обработку данных вообще, не галочку «принимаю условия» - согласие на рекламу.
Допустимые основания сбора: человек оформил заказ, подписался на рассылку, зарегистрировался в приложении или сервисе, оставил контакты в офлайн-точке, зная, зачем их берут. Недопустимые: купленная база, спарсенный список, контакты из чужого источника, база партнера, переданная без ведома людей.
Нарушение здесь бьет по аккаунту, а не по одной кампании: доступ к спискам клиентов отключают. Восстановление - отдельная история с обращением в поддержку и без гарантий.
Практическая сторона
Согласие удобнее собирать заранее и хранить в CRM отдельным полем. Формулировка в форме заказа делается прямой, вроде «согласен на получение рекламных материалов», без сваливания в общий блок про политику конфиденциальности. Дата и способ получения согласия фиксируются - это пригодится и для Google, и для местного регулятора.
Для пользователей из Европейской экономической зоны действует отдельное требование Google: при загрузке данных передается статус согласия каждого человека. Компаниям, которые работают на европейский рынок, это стоит закладывать в схему сбора с самого начала. Смежная тема - режим согласия, там про сигналы согласия на сайте и их влияние на измерения.
Хеширование, о котором шла речь выше, вопрос согласия не отменяет. Оно защищает данные при передаче, но не создает основания для их использования. Клиенту, который говорит «данные же зашифрованы, значит согласие не нужно», это стоит объяснить прямо.
Чем Customer Match отличается от расширенных конверсий
Обе механики берут ваши first-party данные и хешируют их, поэтому в голове они часто склеиваются. Задачи разные.
Расширенные конверсии достраивают измерение: хешированные данные с формы отправляются вместе с конверсией и помогают связать ее с кликом, если куки не хватило. Аудитории оттуда не собираются.
Customer Match строит аудиторию: данные превращаются в сегмент, к которому обращается таргетинг. Измерения он не касается.
Настраиваются они независимо, работать могут параллельно, и обе опираются на одно - корректно настроенное отслеживание конверсий и чистые данные из CRM.
Частые вопросы
Сколько записей нужно, чтобы список клиентов заработал
Порог - 100 активных пользователей за последние 30 дней после сопоставления. Важно, что это порог по совпавшим, а не по строкам файла: чтобы получить сотню активных, загрузить придется заметно больше. И еще одно требование из правил: в списке должно оставаться не меньше 100 участников, добавленных или обновленных за последние 540 дней, иначе он перестанет быть пригодным.
Почему из базы в 5 000 строк совпало меньше половины
Совпадают только контакты, привязанные к аккаунтам Google, у которых была активность. Корпоративные ящики на своих доменах, телефоны, которые человек нигде не указывал, спящие аккаунты - все это в аудиторию не попадет. Плюс формат: телефоны без кода страны и email с пробелами отбрасываются до сравнения. По моим загрузкам в Узбекистане и Казахстане совпадает около 4 000 контактов из 10 000, так что доля в районе сорока процентов - результат нормальный, а не признак испорченной выгрузки.
Нужно ли хешировать данные самому
Нет, при загрузке через интерфейс Google хеширует данные сам. Самостоятельное хеширование алгоритмом SHA-256 нужно, когда клиент не готов передавать контакты в открытом виде или когда работа идет через API. Тогда нормализация - нижний регистр, формат телефона - делается до хеширования, иначе хеши не совпадут.
Можно ли загрузить базу, которую собрали давно и без согласия на рекламу
Формально нет. Google требует согласия на использование данных в рекламе, и ответственность лежит на рекламодателе. При нарушении отключают доступ к механике на уровне аккаунта. Если по старой базе согласия нет, чище провести реактивацию по другому каналу и собрать согласие заново, чем рисковать доступом.
Работает ли Customer Match в Performance Max
Да, база подключается сигналом аудитории - алгоритм использует ее как описание нужного клиента и ищет похожих людей. Отдельно списки используются в цели «Привлечение новых клиентов»: без загруженной базы Google хуже отличает нового покупателя от существующего.
Можно ли построить похожую аудиторию от своей базы
Только в кампаниях Demand Gen - в других типах кампаний похожие сегменты не работают. Исходной базе нужен объем, порядка тысячи совпавших активных пользователей. С 2026 года Google переводит эту механику в режим подсказки: исходная аудитория задает направление поиска, а не жесткую границу.
Что будет, если не обновлять список
Он будет медленно терять объем: часть контактов перестанет совпадать, часть пользователей уйдет из активных. Записи, добавленные или обновленные больше 540 дней назад, из аудитории выпадают. Через полтора года без обновлений список перестанет работать. Отдельная проблема тише: сегментация врет, если статусы клиентов в CRM поменялись, а в Google Ads остались старые.
У меня нет доступа к Customer Match, что делать
Сначала проверить историю нарушений в аккаунте. Дальше посмотреть на пороги: наблюдение и исключения доступны любому аккаунту без нарушений, а таргетинг и корректировки ставок открываются после 90 дней работы и $50 000 суммарных расходов. Работа через управляющий аккаунт агентства с набранной историей - рабочий обходной путь. В чувствительных тематиках вроде медицины механика ограничена независимо от расходов.
Насколько это рискованно с точки зрения защиты данных клиента
Технически в Google уходят хеши, а не контакты, и обратно из них база не собирается. Юридически ответственность за законность передачи остается на компании, которая базу загружает: нужно основание, согласие и понимание местных требований к персональным данным. Отдельный вопрос - кто грузит файл. Я предлагаю клиентам делать это самим: подрядчик говорит, какие поля и в каком формате нужны, а контакты никуда за пределы компании не уходят. Настройку такой порядок не усложняет, зато снимает целый класс вопросов о том, что будет с базой после окончания работы.