SEO-текст: что это и чем отличается от обычной статьи

SEO-текстом раньше называли текст с нужным числом вхождений ключевой фразы, и этого было достаточно. Семь страниц выдачи дают семь разных цифр по плотности - от 1 до 7 процентов. Поиск сегодня оценивает не вхождения, а полноту ответа на запрос и то, закрыл ли человек свою задачу прямо на этой странице. Объем текста в знаках сам по себе не значит ничего. Ориентиром служит текущая выдача по целевому запросу, нормативов тут нет.
Что называли SEO-текстом раньше
До середины десятых поиск работал грубее, чем сейчас. Система сопоставляла слова запроса со словами на странице и считала совпадения: сколько раз фраза встретилась, насколько она редкая в общем массиве документов. На этой арифметике построены алгоритмы TF-IDF и BM25. Они никуда не делись, но сегодня это один сигнал из сотен, а тогда он был почти единственным.
Отсюда и выросла плотность вхождений - доля целевой фразы в общем количестве слов на странице. Автор получал задание вида: 6 000 знаков, фраза «пластиковые окна цена» - восемь раз, обязательно в первом абзаце и в H1. Читателя в этой схеме не было. Был счетчик, под который подгоняли текст, и была позиция, которая от него зависела.
Схема сама себя и похоронила. Тексты стали нечитаемыми, поиск получил лавину страниц, написанных для робота, и начал их отсеивать. Дальше подъехали алгоритмы, которые сопоставляют не слова, а смыслы. Разные формулировки одного запроса сводятся к общему значению, страницу оценивают по тому, отвечает она на вопрос или нет. Механику ранжирования целиком разбираем в статье что такое SEO.
От старого подхода остался словарь, и он до сих пор продается заказчикам. Тошнота, водность, заспамленность, «разбавить синонимами», проверка в текстовом анализаторе, ТЗ с процентом вхождений. Заказчик получает документ с цифрами, и работа выглядит измеримой. Числа при этом считаются по самому тексту и с позицией страницы не связаны.
Плотность ключевых слов: семь источников, семь разных цифр
Самый простой способ проверить, существует ли «правильный процент» - собрать рекомендации из статей, которые сами стоят в топе по запросу про SEO-тексты. Открыл первую страницу выдачи, выписал цифры.
| Источник из топа | Рекомендованная плотность |
|---|---|
| Блог сервиса автоматизации продвижения | 1-3% |
| Блог сетевого агентства | 1,5-3% плюс «одна ключевая фраза на 500-700 знаков» |
| Колонка на площадке для предпринимателей | 2-4% |
| Блог агентства performance-профиля | 3-5 ключевых фраз на 1 000 знаков |
| Отраслевое медиа о рекламе | не выше 6% |
| Блог сервиса рассылок | 5-7% |
| Тематический сайт-миллионник | 5-7% |
Семь источников, семь разных ответов, разброс от одного процента до семи. Все они отвечают на один и тот же вопрос и стоят в топе по этому запросу. Существуй этот порог, у всех семи он был бы одинаковым.
Ни одну из этих цифр никто не выводил экспериментом. Они переписываются из статьи в статью с нулевых, когда плотность действительно влияла на позицию, и с тех пор мутируют, как городская легенда. Поиск за это время сменил модель ранжирования не раз, а числа остались.
Отдельная история - сервисы, которые считают тошноту и водность. Классическая тошнота считается по числу повторов самого частого слова - это корень из количества упоминаний, абсолютная величина. Водность показывает долю служебных слов, местоимений и оборотов без смысла. Обе цифры описывают сам текст, и ни одна из них не знает, по какому запросу продвигается страница, что стоит в топе и чего в вашем материале не хватает.
О технической детали заказчику тоже не говорят. Анализатор часто меряет не то, что вы думаете. Если скормить ему адрес страницы, в подсчет попадают меню, футер, хлебные крошки, иногда скрытые блоки. Объем завышается, тошнота скачет, а автор потом правит текст под цифру, которую сгенерировала навигация сайта.
Дело еще и в том, как поиск обращается с формулировками. Он давно сводит словоформы и синонимы к одному значению: «купить кроссовки», «заказать кроссовки» и «кроссовки с доставкой» для него - варианты одного намерения. Точная фраза оказывается одной из десятка равнозначных, и ее доля в тексте не измеряет ничего.
Это видно на вашем сайте. Откройте в Google Search Console отчет по запросам одной страницы и посмотрите список фраз, по которым она показывается. Там окажутся десятки формулировок, которых в тексте нет ни разу. Поиск сам сопоставил страницу с вопросом. Страница собирает трафик по словам, которых автор не писал, а приемка текста идет по проценту точной фразы.
Совсем эти алгоритмы не умерли. В узких локальных нишах, где по запросу конкурируют пять страниц и ни одна толком не проработана, частота слов еще может решать. Как только тема конкурентная, вес сигнала падает почти до нуля.
Что поиск оценивает вместо вхождений
Если процент не работает, по чему тогда судить о тексте? Пять вещей, которые проверяются без сервисов.
Интент. Что человек хочет получить, а не какими словами он это сформулировал. За запросом «мониторинг конкурентов» может стоять желание выбрать сервис, понять методику или найти цену - и это три разных текста. Интент вытаскивают из выдачи - по тому, какие страницы там стоят и что они дают читателю. Как собирать запросы и раскладывать их по страницам, разбираем в статье про семантическое ядро.
Полнота. Закрыты ли смежные вопросы, которые возникнут у читателя сразу после ответа на главный. Человек спросил, как выбрать сплит-систему, и следом ему понадобится узнать, сколько стоит установка, шумит ли инвертор и можно ли ставить зимой. Текст, который закрывает главный вопрос и обрывается, отправляет читателя обратно в выдачу. Такое поведение поиск фиксирует.
Формат. Если по запросу в топе сплошь пошаговые инструкции, значит поиск уже решил, что человеку нужен порядок действий. Рассуждение на ту же тему проиграет по формату, даже если написано лучше. Формат смотрят глазами по первой странице выдачи.
Факты и названия. Названия инструментов, версии интерфейсов, суммы, сроки, ограничения. То, что нельзя написать, не разобравшись в теме. Текст без фактов пересказывает другие тексты, и поиску незачем поднимать пересказ выше оригинала.
Первоисточник. Что есть у вас, чего нет ни у кого в топе: свои данные, скриншот процесса, результат замера, разбор ошибки, которую вы поймали руками. Конкуренту это повторить сложнее всего: ваших данных у него нет.
До перехода на страницу человек видит другое - заголовок и описание в выдаче. Правила для них разбираем в статье про title и description. По каким запросам страница уже показывается и где недобирает, видно в отчетах Google Search Console. В ответы нейросетей текст попадает по своим правилам оформления: структура текста под цитирование.
Объем: откуда берутся требования в знаках
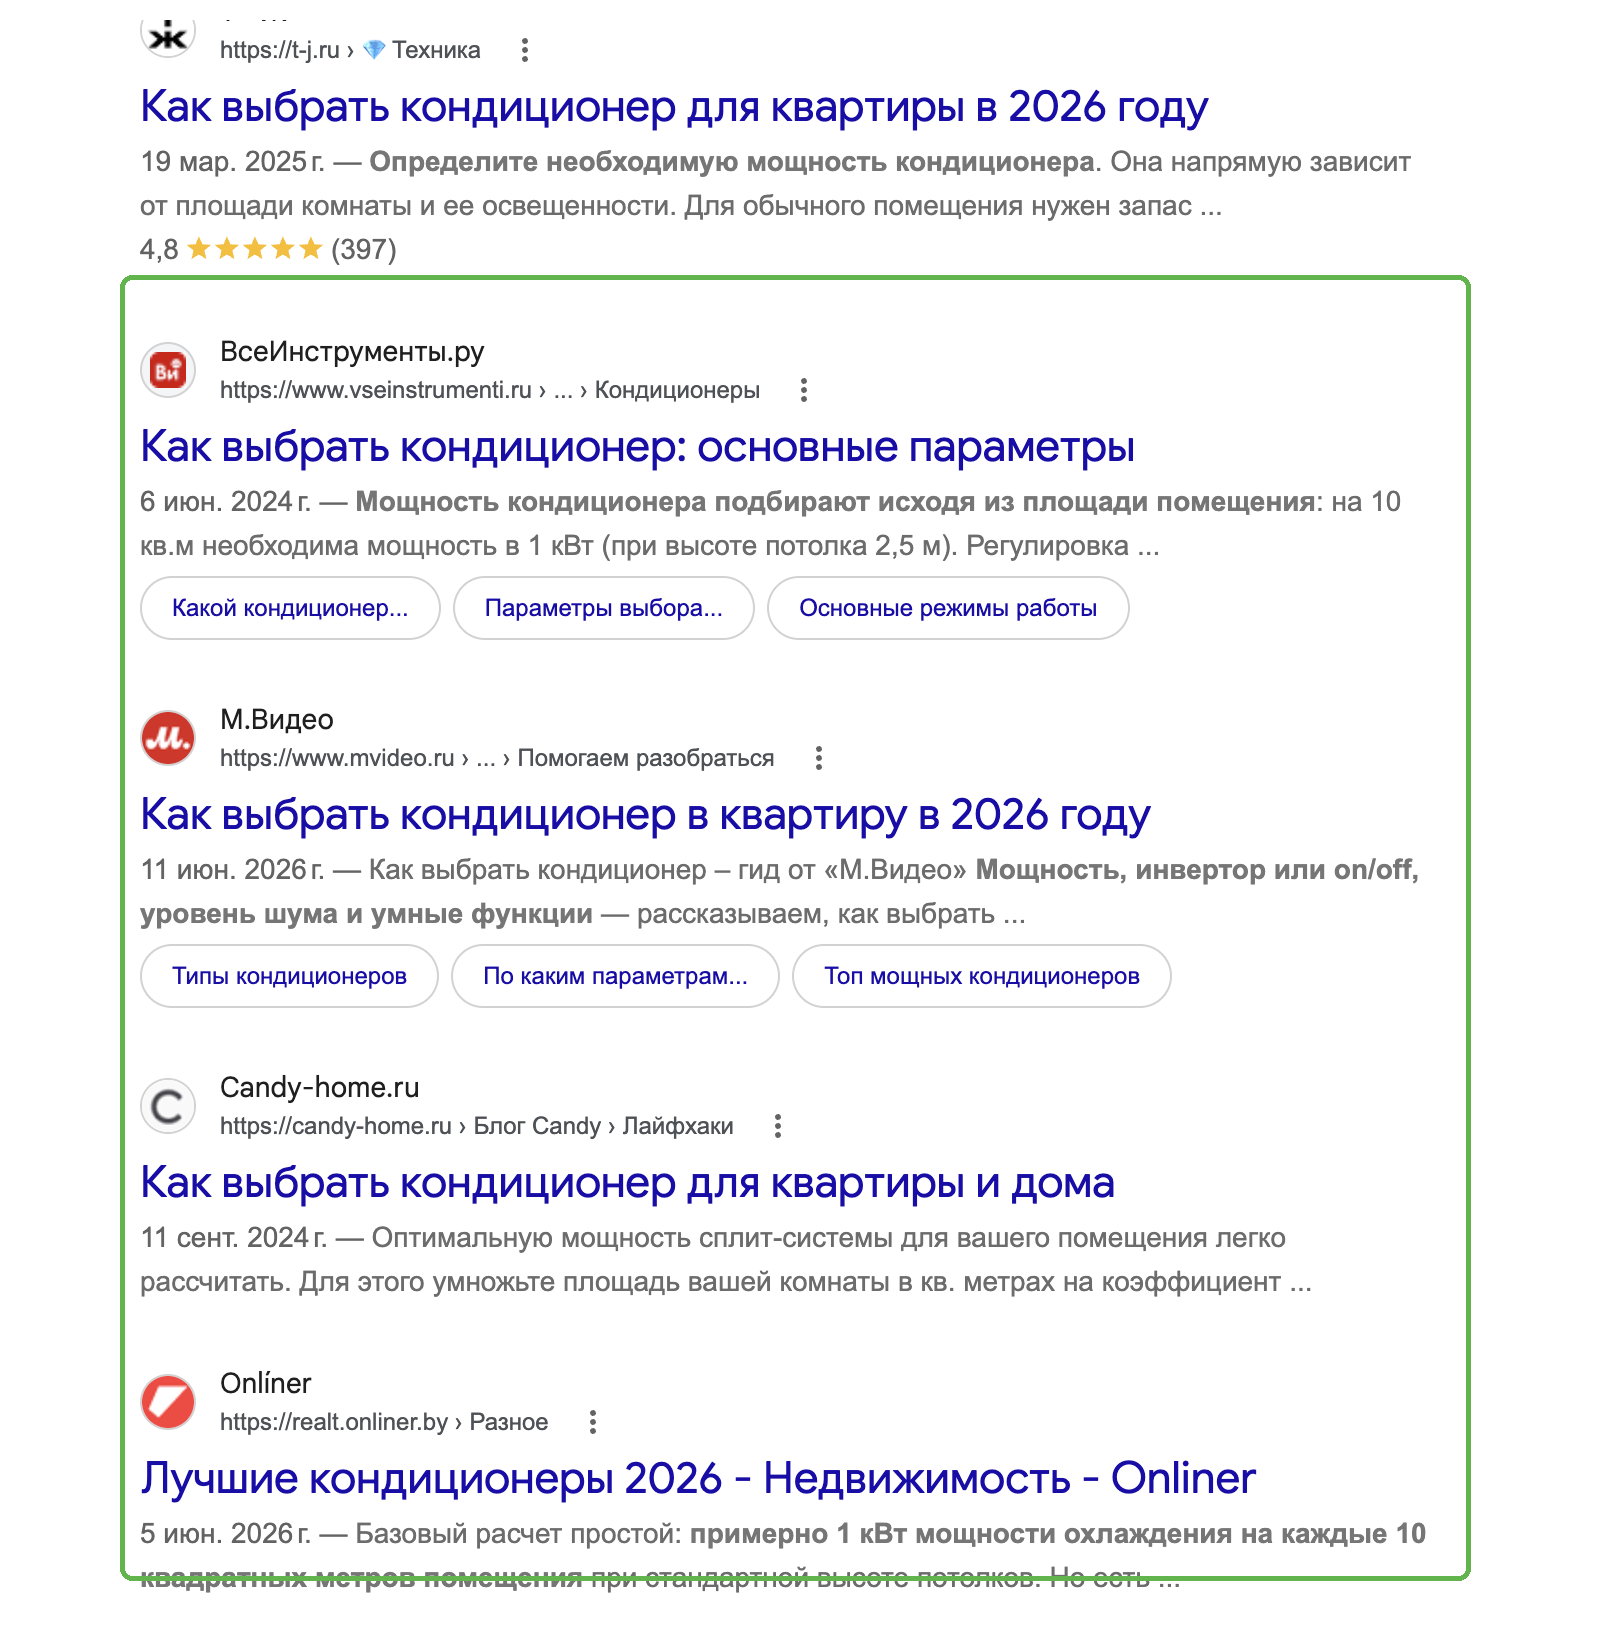
Совет, который кочует по статьям и по ТЗ: посмотрите топ-10, посчитайте средний объем, напишите столько же. Встречаются задания с точностью до сотни знаков - «от 7 600 до 8 000 без пробелов».
Причина и следствие тут перепутаны. Тексты в топе длинные не потому, что длина поднимает страницу, а потому что запрос требует развернутого ответа. Тема сложная, вопросов много, короткий материал их не закрывает. Поиск поднял эти страницы за полноту, а замерили в них знаки.
Обратное тоже верно. По запросу «размер визитки в пикселях» лонгрид проиграет странице на два абзаца: человек хочет число, а получает историю полиграфии на два экрана. В одном топе спокойно стоят рядом страница на 6 000 знаков и материал на 40 000.
Ahrefs разобрал около 40 тысяч страниц и не нашел связи между длиной материала и попаданием в ответы нейросетей. Длинные страницы не всплывают чаще коротких. Google ни разу не называл длину текста фактором ранжирования.
Рабочее правило вместо цифры - считать не знаки, а вопросы, на которые надо ответить. Собрали список вопросов по теме, ответили на каждый по существу, убрали все, что не отвечает ни на один, - получился объем. Выйти может и 1 500 знаков, и 40 000. Оба варианта встречаются в топе по соседним запросам.
Два текста на один запрос: разбор
Ниже два фрагмента под один запрос - «как выбрать кондиционер для квартиры». Слева типовой вариант, который приходит с биржи по нижней ставке рынка, справа переписанный.
| Типовой текст | Переписанный |
|---|---|
| В современном мире кондиционер стал неотъемлемой частью комфортного жилья. Выбор кондиционера для квартиры - ответственная задача, к которой стоит подойти со всей серьезностью. | Для комнаты 18 м² с окном на юг считают так: 1 кВт холода на 10 м² при потолке до 2,7 м, плюс 20-30% на солнечную сторону, технику и людей. Выходит около 2,3 кВт - это модель «09», а не «07», которую берут по привычке. |
| Современные кондиционеры для квартиры обладают целым рядом преимуществ: высокая эффективность, надежность, экономичность и стильный дизайн, который впишется в любой интерьер. | Инвертор дороже обычной модели на 30-40%. Он тише и держит температуру без рывков, поэтому в спальню берут его, а на кухню или в кабинет чаще ставят обычный компрессор. |
| Также при покупке климатической техники важно обратить внимание на такие параметры, как мощность, уровень шума и класс энергопотребления. | Уровень шума внутреннего блока смотрят на максимальной скорости вентилятора: в характеристиках производители указывают обе цифры, а в рекламе оставляют только минимальную. |
| Таким образом, выбрать кондиционер для квартиры не так сложно, как может показаться на первый взгляд. Главное - подойти к вопросу ответственно и учесть все нюансы. | Установка стоит от 25% цены самого кондиционера и часто съедает разницу между моделями. Считать бюджет имеет смысл сразу с монтажом, штробой и трассой нужной длины. |
Разберу левую колонку по пунктам.
Первый абзац объясняет термин вместо ответа. Человек, который ищет, как выбрать кондиционер, уже знает, что такое кондиционер. Он пришел за расчетом мощности и получил сообщение, что жилье бывает комфортным. Правая колонка отвечает первой же строкой.
Обороты, которые ничего не сообщают. Заход про современный мир, призыв отнестись серьезно, оговорка про кажущуюся сложность. Три абзаца из четырех слева держатся на таких оборотах. Уберите их - смысл не изменится, а объем заметно упадет.
Преимущества без единого числа. Надежность, экономичность, стильный дизайн. Под эти слова подходит любой кондиционер и любой холодильник. Справа вместо экономичности стоит наценка на инвертор в 30-40%, вместо уровня шума - объяснение, какую из двух цифр производителя смотреть.
Ключевая фраза, вписанная неестественно. Фраза «кондиционер для квартиры» стоит в трех абзацах из четырех, каждый раз целиком, без сокращений и замен. Так люди не пишут - так текст подгоняют под задание. Поиск давно понимает «сплит-система в спальню» и «кондиционер для квартиры» как одно и то же, а читатель спотыкается о повтор.
Финал-обобщение вместо вывода. «Главное - подойти к вопросу ответственно» не сообщает ничего. Полезный финал добавляет то, о чем читатель не подумал: например, что монтаж съест разницу между моделями и считать надо сразу с ним.
Разница между колонками не в стиле. Слева писали про тему вообще, справа - для человека, который сегодня вечером выбирает модель и считает бюджет вместе с установкой.
Машинный текст: новая версия переспама
Двадцать лет назад текст браковали за переспам. Сейчас чаще за однородность: текст грамотный и гладкий, но неотличимый от сотни таких же. Нейросеть выдает ровные абзацы и стандартный набор связок между мыслями.
Признаки, по которым это видно заказчику без сервисов:
- Абзацы как под линейку: три-четыре предложения в каждом, без единого короткого
- Связки-паразиты в начале абзацев: «кроме того», «таким образом», «стоит отметить», «в свою очередь»
- Конструкция «не X, а Y» там, где никакого противопоставления нет
- Пункты списка начинаются одинаково и держат один уровень детализации
- Финалы-афоризмы: раздел закрывается красивой обобщающей фразой вместо факта
- Длинное тире там, где в русском тексте стоит запятая или двоеточие
- Ноль конкретики: ни одного числа, названия или срока, который нельзя было бы придумать
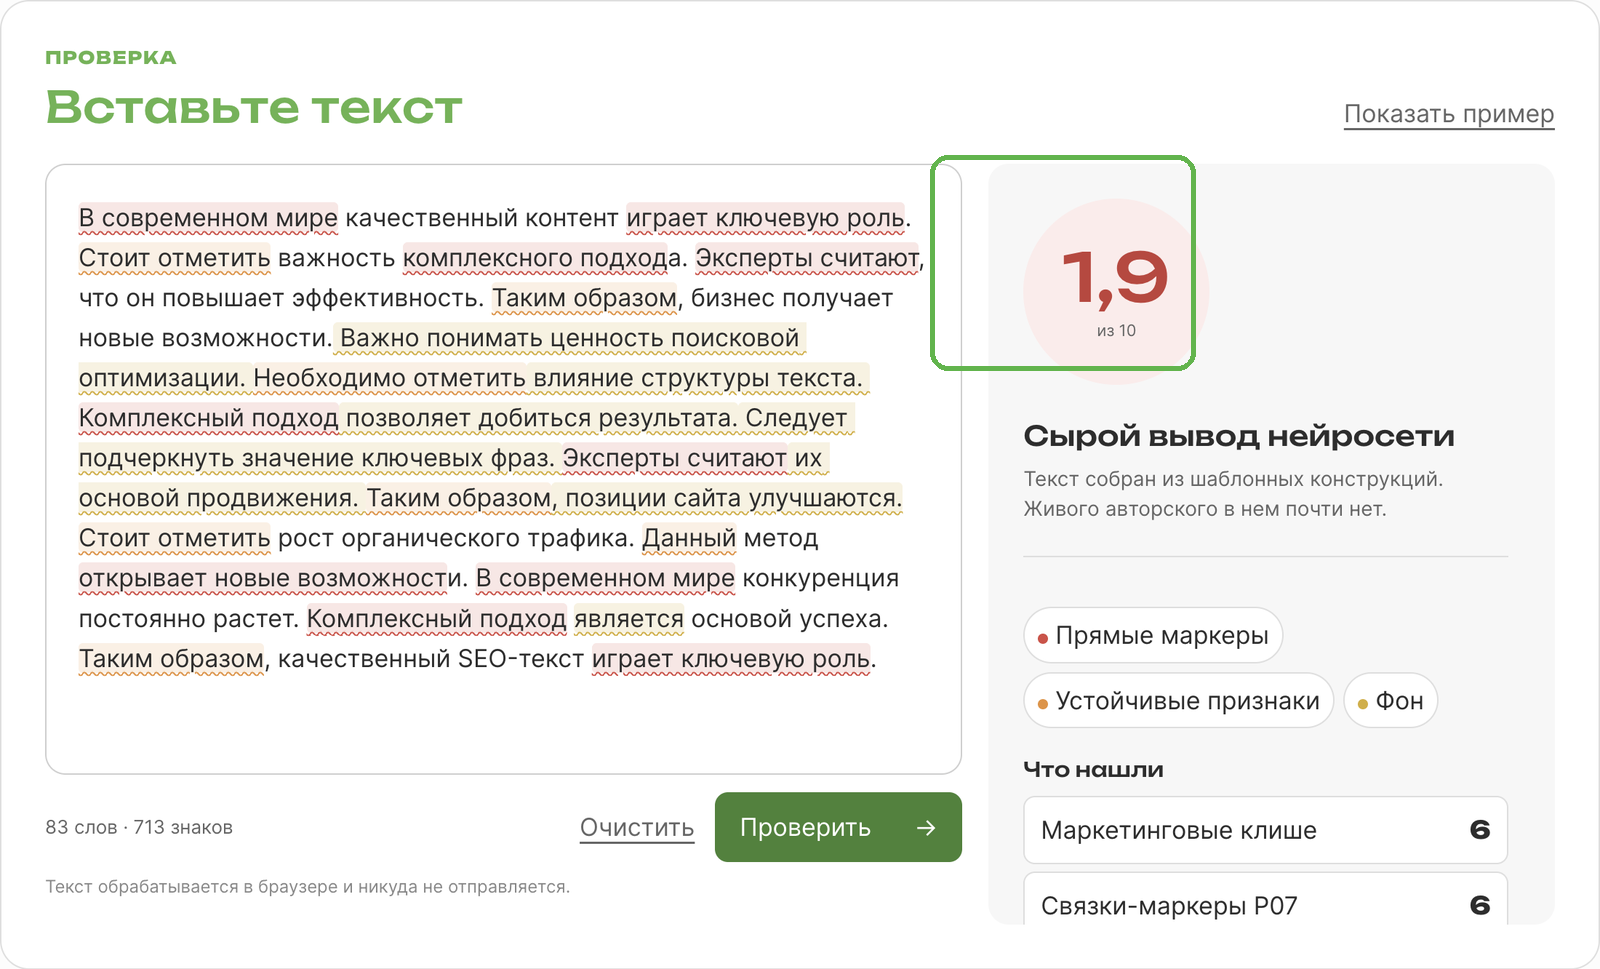
Проверка автоматом помогает, но верить ей на слово не стоит. Детекторы регулярно помечают как машинные тексты, написанные людьми. Аккуратный редактор с ровной грамматикой набирает 70% машинности и выше уже за чистоту письма. Разметка добавляет процентов сама по себе: модели пишут в markdown, и детекторы это учитывают.
Итоговая оценка мало что дает. Смотреть надо на подсвеченные куски. Там оказываются ровно те конструкции, которые перечислены выше. Прогнать свой текст можно в проверке текста на ИИ.
При заказе это значит одно. Требуйте от автора фактуру, которой нет в открытых источниках, и разрешите неровный ритм. Абзац в одну строку - нормально. Список из пунктов разной длины - тоже. Стоп-лист выражений и порядок приемки разбираем в статье про ТЗ копирайтеру.
Кто должен писать: копирайтер, эксперт или связка
Три рабочие модели, у каждой своя цена и свой потолок.
Копирайтер по заданию. Дешево и быстро, масштабируется на любой объем. Работает на темах, где ответ есть в открытых источниках и требуется аккуратная сборка: обзоры, подборки, простые инструкции. Потолок упирается в фактуру: того, чего нет в интернете, копирайтер не напишет. Качество наполовину зависит от того, разбирается ли автор в предмете. Копирайтер с профильным образованием в медицине или технике дает результат другого порядка, чем универсал.
Эксперт пишет сам. Фактура появляется сразу, спорные места закрываются на месте. Проблема одна, зато тяжелая: скорость. Практикующий специалист выдает статью за одну-две недели и закрывает две-три штуки в месяц в лучшем случае. На объемах блога это 10-15% нужных материалов, остальное все равно кто-то должен писать.
Связка. Эксперт дает материал - расшифровку разговора, скриншоты, цифры, разбор случая. Копирайтер собирает из этого текст по заданию, эксперт вычитывает факты. Скорость приближается к первой модели, фактура - ко второй. Стоимость складывается из двух частей и все равно выходит дешевле, чем часы эксперта.
На практике это выглядит так: сорок минут разговора с экспертом под запись, расшифровка, из нее вытаскивают цифры, названия и случаи из работы. Копирайтер пишет по заданию и расшифровке. Эксперт вычитывает только факты, стиль не трогает - одна вычитка вместо трех переписываний.
У связки есть условие, без которого она разваливается. Задание пишет не копирайтер и не эксперт, а тот, кто смотрел выдачу по запросу и знает, какие вопросы там закрыты, а какие нет. Иначе выходит грамотный текст не по тому запросу - читается хорошо, а показывается по фразам, за которыми никто не приходит. Сколько это стоит по рынку - отдельный разговор.
Что от SEO-текста осталось
Термин остался в обиходе, метод под ним поменялся полностью. SEO-текстом сегодня зовут материал, который закрывает вопрос читателя целиком, а инструменты старой школы считают совсем другое. Тошнота меряет частоту слова, водность - долю служебных оборотов, уникальность - совпадение символов с чужими страницами. Ни одна из этих цифр не говорит, попадет страница в топ или нет.
От обычной статьи такой материал отличается не стилем письма, а порядком работы: сначала запрос и выдача, потом структура, и только потом текст.
Вместо процентов заказчику остаются четыре действия. Посмотреть выдачу по запросу и сравнить формат. Проверить, отвечает ли первый абзац на вопрос. Посчитать в тексте факты, которые нельзя было бы придумать. И прочитать вслух пару абзацев подряд: пересказ слышно сразу, по гладким формулировкам, за которыми нет ни одной проверяемой детали.
Частые вопросы
Что такое SEO-текст простыми словами?
Это текст на сайте, написанный под конкретный поисковый запрос. Он отвечает на вопрос, который человек задал поисковой системе, и оформлен так, чтобы она поняла, о чем страница. От обычной статьи отличается точкой старта. Тему и структуру задает спрос: сначала смотрят, что и как спрашивают в поиске, потом пишут.
Нужна ли уникальность 100%?
Нет. Порога в 100% не требует ни один поиск, а в темах с устоявшейся терминологией он недостижим. Названия препаратов, законов, моделей и настроек совпадают у всех. Разумный ориентир по популярным сервисам проверки - 80-95%. Гнаться за последними процентами вредно: автор начинает заменять точные термины синонимами, и текст теряет смысл.
Что такое тошнота и водность, надо ли за ними следить?
Тошнота показывает перекос по повторам: одно слово встречается заметно чаще всех прочих. Водность - какую долю текста занимают служебные слова и обороты без содержания. Обе метрики считаются по тексту и ничего не знают о выдаче. Как критерий приемки не годятся. Косвенная польза есть: зашкаливающая тошнота выдает принудительно вставленную фразу, высокая водность - разбавленные абзацы.
Кто такой SEO-копирайтер и чем он отличается от обычного?
Тот же копирайтер, который дополнительно работает с заданием под запрос - держит структуру разделов, отвечает на смежные вопросы, следит за заголовками и описанием страницы. Разница в отправной точке: он стартует от вопроса читателя и уже под него собирает тему. Автор, который умеет только рассыпать фразы по тексту, остался без работы еще до появления нейросетей.
Сколько стоит SEO-текст?
Цена зависит от того, кто пишет и сколько фактуры дает заказчик. Низ биржи - пара долларов за тысячу знаков, средняя ставка за сборку из открытых источников подросла до 5-6 долларов, несколько лет назад она была в разы ниже. Текст с расшифровкой разговора, своими цифрами и вычиткой эксперта стоит кратно дороже, потому что в него входят часы самого эксперта. Модели оплаты и диапазоны по рынку разбираем в статье про стоимость продвижения.
Можно ли писать тексты нейросетью?
Как черновик и помощника по структуре - можно, это уже норма. Готовый текст на сайт из модели не выходит: она пересказывает написанное другими и выдает узнаваемо ровные абзацы без фактов. Рабочая схема выглядит иначе - человек дает фактуру и правит ритм, модель ускоряет сборку. Перед публикацией текст стоит прогнать через инструмент проверки на машинное происхождение.