Признаки ИИ-текста: как отличить текст нейросети от текста человека

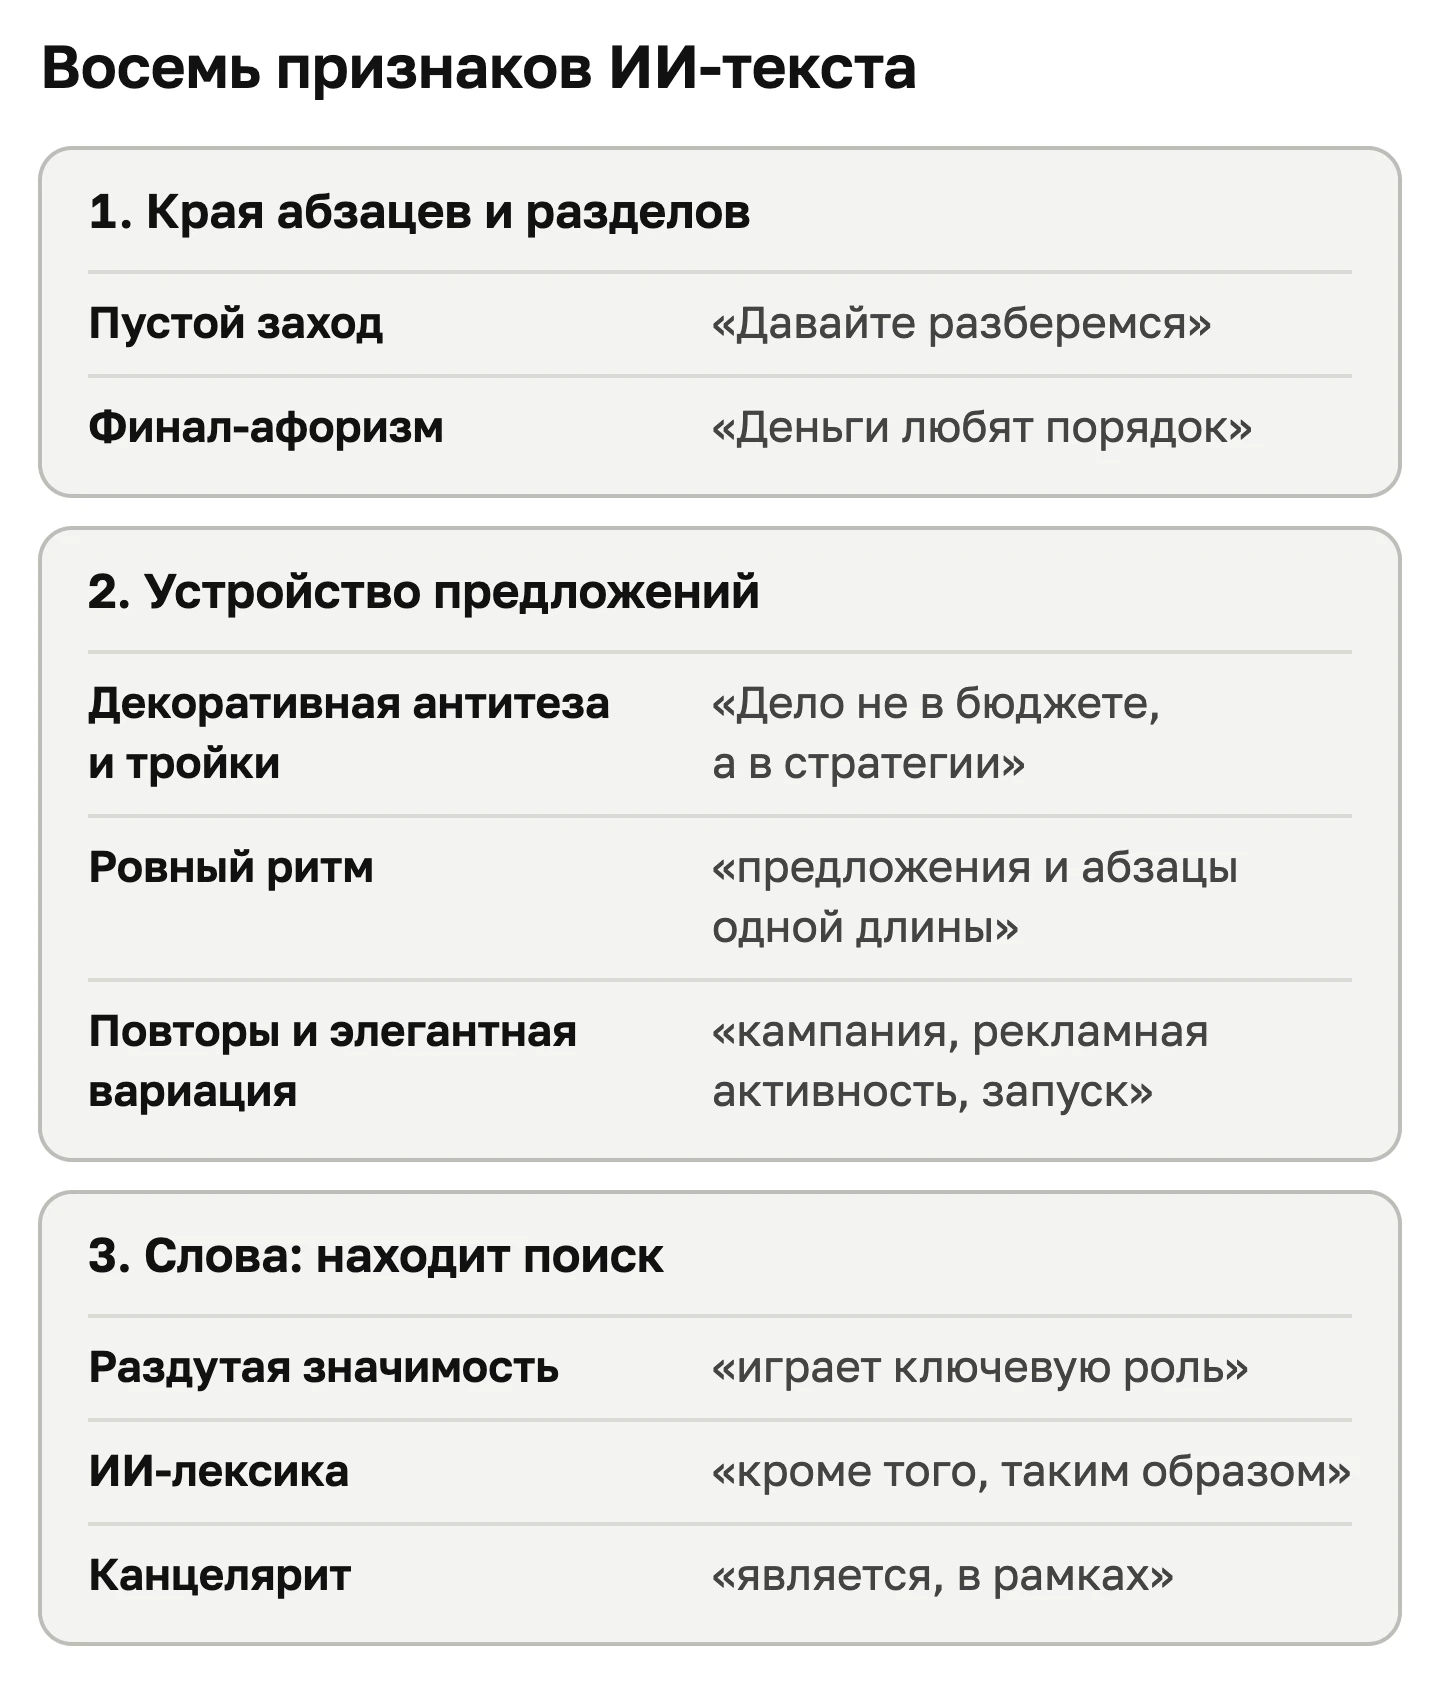
Текст нейросети выдает сочетание признаков: пустые заходы, антитезы «не X, а Y», ровный ритм, финалы-афоризмы, раздутая значимость, ИИ-лексика, канцелярит и повторы. Один признак встречается и у людей. Три-четыре в одном абзаце уже сигнал. Детекторы ошибаются в обе стороны: помечают тексты людей и пропускают отредактированные ответы модели. Вывод делает редактор, детектор дает только повод присмотреться.
Копирайтер или подрядчик сдал текст. Ошибок нет, структура на месте, но читается он как десяток других текстов на ту же тему. Проверить, писала ли его модель, можно без детектора. У машинного текста восемь повторяющихся признаков, и все они видны при внимательном чтении. У каждого есть объяснение, почему модель так пишет, и исключения, когда так же пишут люди. На проверку статьи уходит около десяти минут.
Почему ИИ-текст узнается без сервисов?
Языковая модель пишет текст по шагам и на каждом шаге выбирает вероятное продолжение. Google описывает механику так же на странице о генеративном контенте: модели предсказывают вероятные последовательности слов и поэтому могут ошибаться (страница обновлена 01.10.2026, проверено 10.11.2026).
Вероятное продолжение тянется к самым частым словам и оборотам из обучающих текстов, а дообучение на оценках людей сдвигает ответ к формулировкам, которые устраивают большинство. Отсюда усредненный стиль. Два подрядчика, которые независимо друг от друга сгенерировали текст на одну тему, сдают похожие абзацы с одними и теми же связками. Редактор, через которого проходит много текстов, замечает это раньше, чем успевает объяснить, что его смущает. Для заказчика SEO-текстов машинный текст стал новым переспамом: его бракуют за однородность, как раньше браковали за избыток ключевых фраз.
Свой список признаков ведут редакторы Википедии: руководство «Signs of AI writing» собрал проект WikiProject AI Cleanup, который работает с 2023 года. Список составлен из оборотов и приемов, которые раз за разом всплывают в правках моделей. Полагаться только на автоматические детекторы авторы руководства не советуют: они угадывают лучше случайного выбора, но ошибаются заметно часто (проверено 10.11.2026).
Кристиан Кузнецов и соавторы (Findings of ACL 2025, препринт вышел в марте 2025 года) разобрали работу детектора с помощью разреженных автокодировщиков на модели Gemma-2-2B. Среди признаков, на которые опирается детектор, нашлись многословные вступления и излишняя синтаксическая сложность. Авторы пишут, что у современных моделей есть узнаваемый стиль. Сильнее всего он заметен в текстах, насыщенных информацией, хотя с менее формальной, персонализированной инструкцией модели умеют писать как человек.
Признак говорит о вероятности: так чаще пишет модель. Уликой он не служит, потому что каждый из восьми можно найти и в тексте человека.
Восемь признаков удобно делить по месту, где их искать. Заходы и финалы стоят на краях абзацев и разделов, поэтому для первой проверки хватает начала и конца каждого раздела. Антитезы, ровный ритм и повторы видны в устройстве предложений. Заменой слов их не убрать. Раздутую значимость, ИИ-лексику и канцелярит ловит поиск по словам.
Пустые заходы и мостики-анонсы
Пустой заход - фраза, которая обещает содержание и сама ничего не сообщает. Чаще она стоит первой в абзаце или разделе: «Давайте разберемся, как это работает», «И вот здесь начинается самое интересное», «Логика простая:», «Важно понимать, что». Отдельный вид - открытие статьи с общего места: «В современном мире цифрового маркетинга», «Не секрет, что».
Находят его за секунды. Закройте первую фразу абзаца ладонью и прочитайте остальное. Если смысл не изменился, фраза была пустой.
Было. Давайте разберемся, почему кампания в Telegram Ads не расходует бюджет. Причина проще, чем кажется, и кроется в настройках. Узкая тематика каналов при низкой ставке дает мало показов.
Стало. Кампания в Telegram Ads не расходует бюджет из-за узкой тематики каналов: при низкой ставке объявлению не хватает показов.
Модель пишет по привычке диалога: сначала показывает, что поняла вопрос, обещает ответ и только потом отвечает. В чате такая вежливость уместна. В статье от нее остается абзац-прихожая, который читатель пролистывает. Кузнецов и соавторы нашли этот же признак внутри детектора: у них он называется «многословные вступления».
Людям мостики тоже свойственны, особенно в устной речи. Спикер на вебинаре говорит «смотрите, тут важный момент», чтобы слушатели успели переключиться. В расшифровке интервью такие фразы нормальны и признаком не считаются. В статье читатель сам выбирает темп, и мостик ему мешает.
Близкий родственник захода - риторический вопрос, на который автор отвечает в следующей же фразе: «Что это значит для рекламодателя? Это значит, что...». В заголовке раздела или в блоке FAQ он уместен, а посреди абзаца работает как тот же мостик и тянет время.
На каком шаге правки убирают заходы, показано в статье как убрать пустые заходы.
Антитезы «не X, а Y» и правило трех
Декоративная антитеза - противопоставление тому, чего никто не утверждал. Читателю показывают ошибочное мнение и тут же его исправляют, отсюда ощущение вывода. Только мнение это выдумано: «Реклама в Telegram - это не просто показы, а диалог с аудиторией», «Дело не в бюджете, а в стратегии», «Это не про охваты, это про доверие». Модель тянется к этой конструкции, потому что она звучит как вывод и не требует нового факта.
Несущий контраст устроен иначе. В нем существуют обе стороны, и выбор между ними меняет цифру или действие: «Заявки считают по CRM, а не по событиям в кабинете: кабинет засчитывает и спам, и повторные отправки формы». Обе цифры есть в отчетах, и читатель может взять неверную.
Отличить одно от другого помогает вопрос: кто утверждает отвергнутую сторону? Если в практике читателя есть люди, которые так считают и так делают, контраст несущий. Если отвергнутая сторона появилась в тексте только для того, чтобы ее опровергнуть, конструкцию можно заменить прямым утверждением, и смысл не пострадает.
Правило трех - перечисление из трех однородных элементов там, где хватило бы одного или двух: «быстро, просто и эффективно», «прозрачность, гибкость и масштабируемость». Тройка звучит законченно, поэтому модель добирает третье слово, даже если сказать нечего. Часто третий элемент повторяет первый другими словами. Сюда же относится тройное «не»: «не на интуиции, не на догадках, не на трендах».
Люди пишут так в рекламе и публичных выступлениях. Слоган из трех слов - обычный прием копирайтера, и на лендинге признаком он не служит. В информационной статье настораживает частота: две-три антитезы на экран текста и тройки в каждом втором абзаце.
Ровный ритм: одинаковые предложения и абзацы
Ровный ритм - текст из предложений и абзацев примерно одной длины. В нем нет ни фразы в пять слов, ни длинного предложения на три строки, а абзацы выглядят как нарезанные по линейке. По отдельным словам такой текст не поймать: в нем может не оказаться ни одного штампа.
Ритм выдает модель надежнее, чем лексика. Синонимайзер меняет слова за минуту, а длина предложений и абзацев после него остается прежней. Поэтому текст после синонимайзера узнается по ритму, даже когда штампов в нем не осталось.
Длину предложения модель подбирает по вероятности, так же как слова. У человека длина фразы зависит от мысли: простая мысль укладывается в пять слов, условие с оговоркой занимает тридцать. Модель сглаживает оба края, и текст ложится в середину.
На экране признак виден по форме текста. Три абзаца подряд по три-четыре предложения, каждое на полторы-две строки. Пункты списка одной длины, и каждый начинается с одной части речи. Соседние абзацы открываются по одной схеме: подлежащее, сказуемое, дополнение.
Чтобы посчитать вручную, возьмите десять предложений подряд из середины текста и выпишите, сколько в каждом слов: у человека рядом окажутся фразы в четыре слова и в тридцать. В сыром ответе модели числа держатся в узком коридоре, и коротких среди них почти нет. При вычитке ритм считают ровным, если больше половины предложений укладывается в 12-22 слова. Граница условная. Исследованием она не подтверждена, но решить, перечитывать ли текст внимательнее, она помогает. Ровным бывает и текст из коротких фраз, как в образце «Было» про ретаргетинг: все четыре предложения в нем длиной 8-10 слов. Поэтому смотрят прежде всего на разброс длины, а коридор подсказывает, где перечитать.
Еще один способ - прочитать текст вслух. Ровный текст звучит монотонно уже на втором абзаце, голосу не на чем остановиться.
Было. Ретаргетинг помогает вернуть пользователей, которые уже посещали сайт. Для его настройки нужно создать аудиторию на основе данных пикселя. После этого аудиторию можно использовать в рекламных кампаниях. Важно регулярно обновлять креативы, чтобы избежать выгорания аудитории.
Стало. Ретаргетинг показывает рекламу тем, кто уже был на сайте. Аудиторию собирает пиксель. Кто положил товар в корзину и ушел, видит объявление с этим товаром, а кто прочитал одну статью в блоге, получает рекламу реже и с другим предложением, потому что до покупки ему еще далеко.
Ровно пишут и люди, которых учили писать «правильно», например юристы и авторы отчетов. Неноситель языка тоже часто пишет ровно: он строит фразы по одному образцу, в котором уверен.
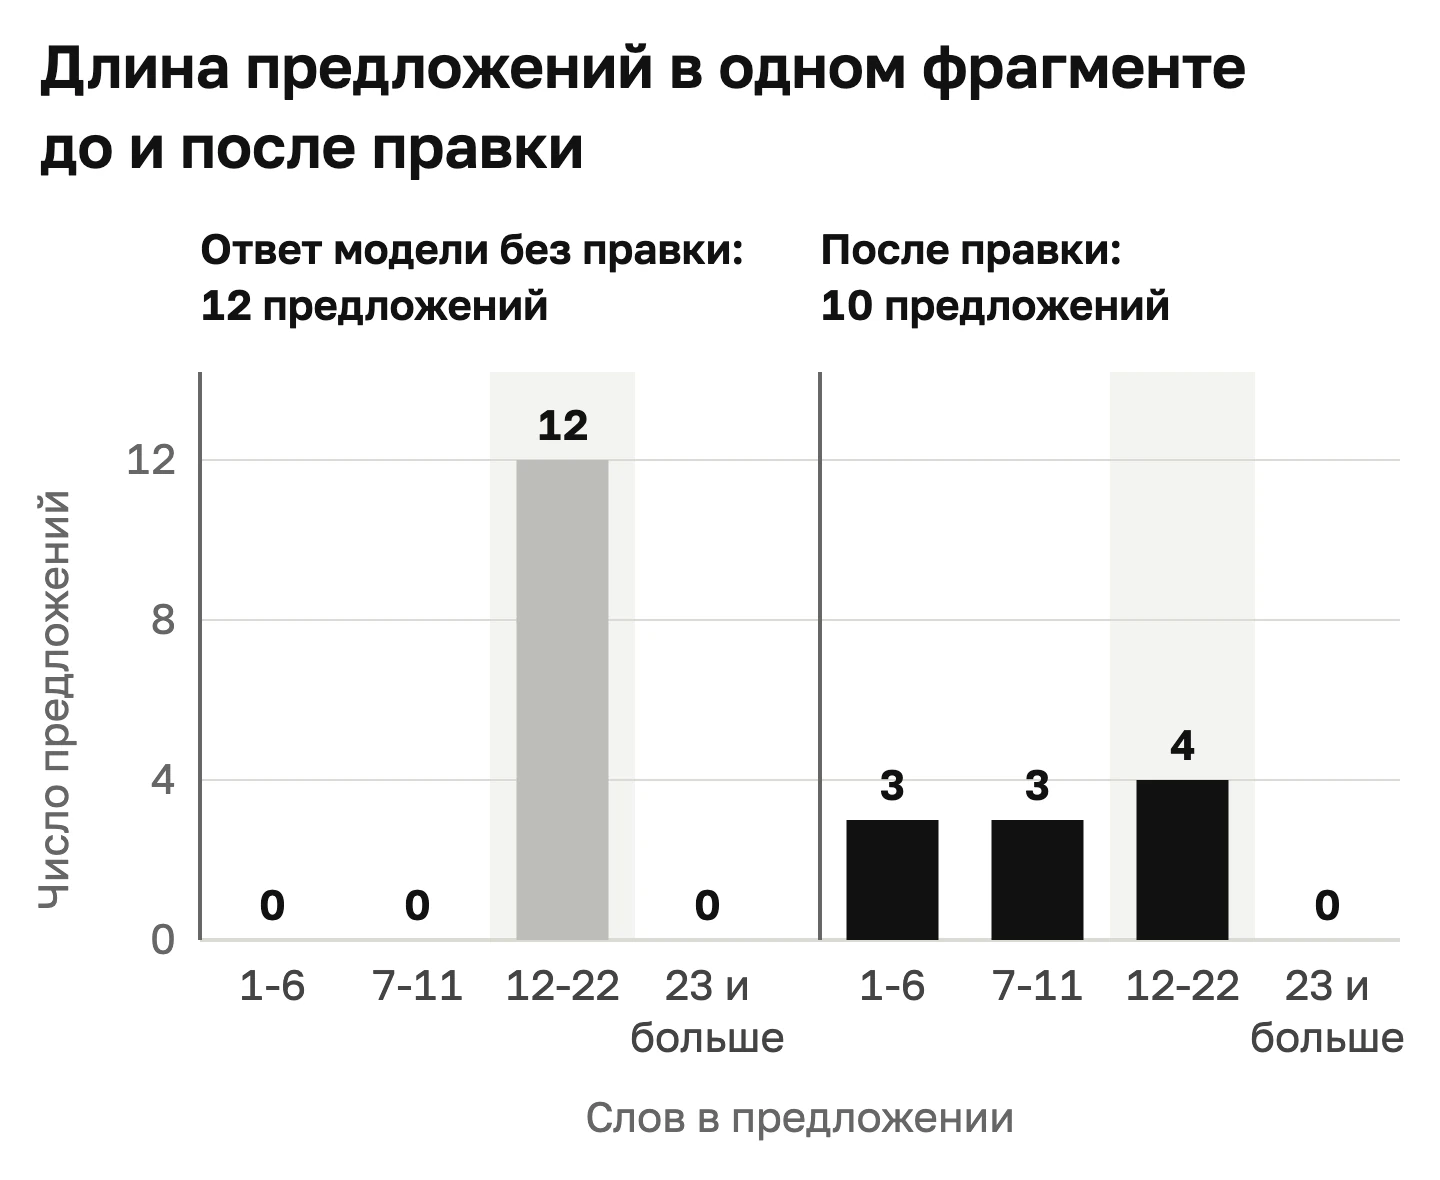
Приемы, после которых ритм перестает быть ровным, а текст не становится рубленым, собраны в статье как разбить ровный ритм.
Финалы-афоризмы и раздутая значимость
Финал-афоризм
Финал-афоризм - последняя фраза абзаца или раздела, которая звучит как лозунг и не добавляет факта: «Деньги любят порядок», «Так и рождается результат», «В этом и есть сила системного подхода». В текстах, на которых училась модель, разделы часто заканчиваются выводом, и модель закрывает обобщением каждый фрагмент, даже если выводить нечего.
Тест тот же, что для заходов, только с конца. Уберите последнюю фразу раздела. Если не пропало ни одной цифры и ни одного действия, фраза была украшением. Финал по делу заканчивается фактом или шагом: «После правки кампания расходует бюджет равномерно до вечера».
В авторской колонке или посте афоризм в конце допустим. Признаком он становится, когда так заканчивается каждый раздел статьи подряд.
Раздутая значимость
Раздутая значимость - оценка без опоры: тему объявляют важной и не показывают почему. Типичные формулы: «играет ключевую роль», «важный шаг», «критически важно», «открывает новые возможности». Рядом идут рекламные эпитеты: «уникальный», «инновационный», «комплексный».
В руководстве Википедии преувеличенная значимость и перечисление мелких упоминаний в СМИ, которые должны сделать предмет статьи заметнее, идут отдельными признаками. Рекламный язык руководство теперь относит к историческим признакам: так чаще писали модели 2023-2025 годов (проверено 10.11.2026).
Модель не знает, что в теме имеет вес для конкретного читателя, и помечает важным все подряд. В абзаце, где три вещи названы ключевыми, не выделена ни одна. Человек, который знает тему, дает оценку один раз и ставит рядом довод, например цифру или последствие ошибки.
Пресс-релизы и продающие страницы пишут с эпитетами по законам жанра, поэтому в них признак мало что говорит. В информационной статье, где читатель ждет фактов, признак заметен сразу, и оценку там лучше заменить фактом.
Лексика, канцелярит и повторы
ИИ-лексика и усилители
ИИ-лексика - слова, которые модель ставит чаще людей и вставляет почти в любой контекст: «ключевой», «нюанс», «значимый», «реальный», «эффективный». В тот же список входят пустые усилители «именно», «просто», «по сути». В русском тексте модели есть еще одна группа - связки в начале абзаца: «Кроме того», «Таким образом», «Стоит отметить», «В свою очередь».
Одно такое слово ничего не доказывает, все они есть в словаре и в речи людей. Смотреть надо на плотность. Если связка из этого списка открывает каждый второй абзац, текст собран по шаблону.
К лексике примыкает типографика. Модели переносят в русский текст английские привычки: ставят длинное тире там, где по-русски хватило бы запятой или двоеточия, и пишут заголовки с заглавной буквы в каждом слове. Само по себе тире входит в нормы русской пунктуации. Подозрительны тире почти в каждом предложении и заголовки, оформленные по английским правилам. Избыток длинного тире английское руководство Википедии перенесло в исторические признаки: новые модели с осени 2026 года тире почти не ставят (проверено 10.11.2026).
Канцелярит и номинализация
Канцелярит - обороты из деловых бумаг в тексте, который читают ради пользы: «является», «позволяет», «представляет собой», «данный», «в рамках». Номинализация - отглагольное существительное на месте глагола: «принятие решения», «выполнение настройки». Существительные легко нанизываются друг на друга: фраза выглядит солидно, а действие из нее пропадает. Модель берет эти обороты из деловых текстов, на которых училась: там их много, и они подходят к любой теме.
Есть еще хвост в конце фразы, деепричастный или с оборотом «что делает»: «..., подчеркивая важность регулярного анализа», «..., что делает кампанию еще более результативной». Хвост повторяет мысль предложения. В руководстве Википедии такой хвост описан внутри признака «поверхностный анализ»: в английском тексте это оборот с причастием на -ing в конце фразы, в русском ему соответствует деепричастный оборот.
В договорах и инструкциях канцелярит - норма жанра, и «является» там никого не выдает.
Повторы и элегантная вариация
Элегантная вариация - один предмет под разными названиями. В первом абзаце «кампания», во втором «рекламная активность», в третьем «запуск». Модель избегает повтора слова и подставляет синоним, а читатель видит три разных объекта и ищет между ними разницу, которой нет. Специалист во всех трех абзацах напишет «кампания». Кузнецов и соавторы нашли излишнюю замену синонимами среди признаков внутри детектора. Английское руководство Википедии относит этот признак к историческим: чаще его давали старые модели (проверено 10.11.2026).
Второй вид повтора - смысловой. Одна мысль звучит в начале раздела, в середине другими словами и в конце как вывод. Объем растет, информации не прибавляется. Яндекс в справке Вебмастера называет похожие признаки малополезного контента: предложения, добавленные ради объема, и циклическое повторение одних и тех же рассуждений (проверено 10.11.2026).
Повтор мысли встречается и у людей: так пишет автор, которому задали объем в знаках.
Как вернуть глаголы и один термин вместо трех, показано в статье как убрать канцелярит.
Когда признаки обманывают: человек пишет как нейросеть
Ошибиться проще всего на трех типах текстов, где люди сами пишут по шаблону.
- Канцелярские жанры. Договор, отчет, техническое задание, инструкция. Номинализацию и «является» там требует жанр.
- Тексты неносителей языка. Человек, для которого русский второй язык, строит фразы по проверенным образцам и выбирает частые слова. Текст выходит ровным и предсказуемым.
- Работа аккуратных редакторов. Чистая грамматика и ровные абзацы без единой разговорной фразы. Чем тщательнее вычитан текст, тем сильнее он похож на машинный.
Модели учились на текстах людей и переняли их привычки. Канцелярит и ровные абзацы были в деловых текстах задолго до нейросетей, модели только стали воспроизводить их чаще и плотнее.
Детекторы тоже ошибаются, и это измерено. OpenAI запустила классификатор AI Classifier в январе 2023 года и отключила его в июле того же года из-за низкой точности. На тестовом наборе английских текстов он верно помечал 26% текстов, написанных ИИ, и ошибочно считал машинными 9% текстов людей.
В исследовании Стэнфорда (Liang и соавторы, журнал Patterns, июль 2023) семь детекторов проверили на эссе экзамена TOEFL, которые написали неносители английского. В среднем детекторы пометили как ИИ 61% таких эссе. Около 20% эссе получили метку ИИ от всех семи детекторов. Цифры относятся к английскому языку, на русский их напрямую не перенести. Механика при этом общая. Простая лексика и предсказуемые обороты делают текст человека похожим на ответ модели.
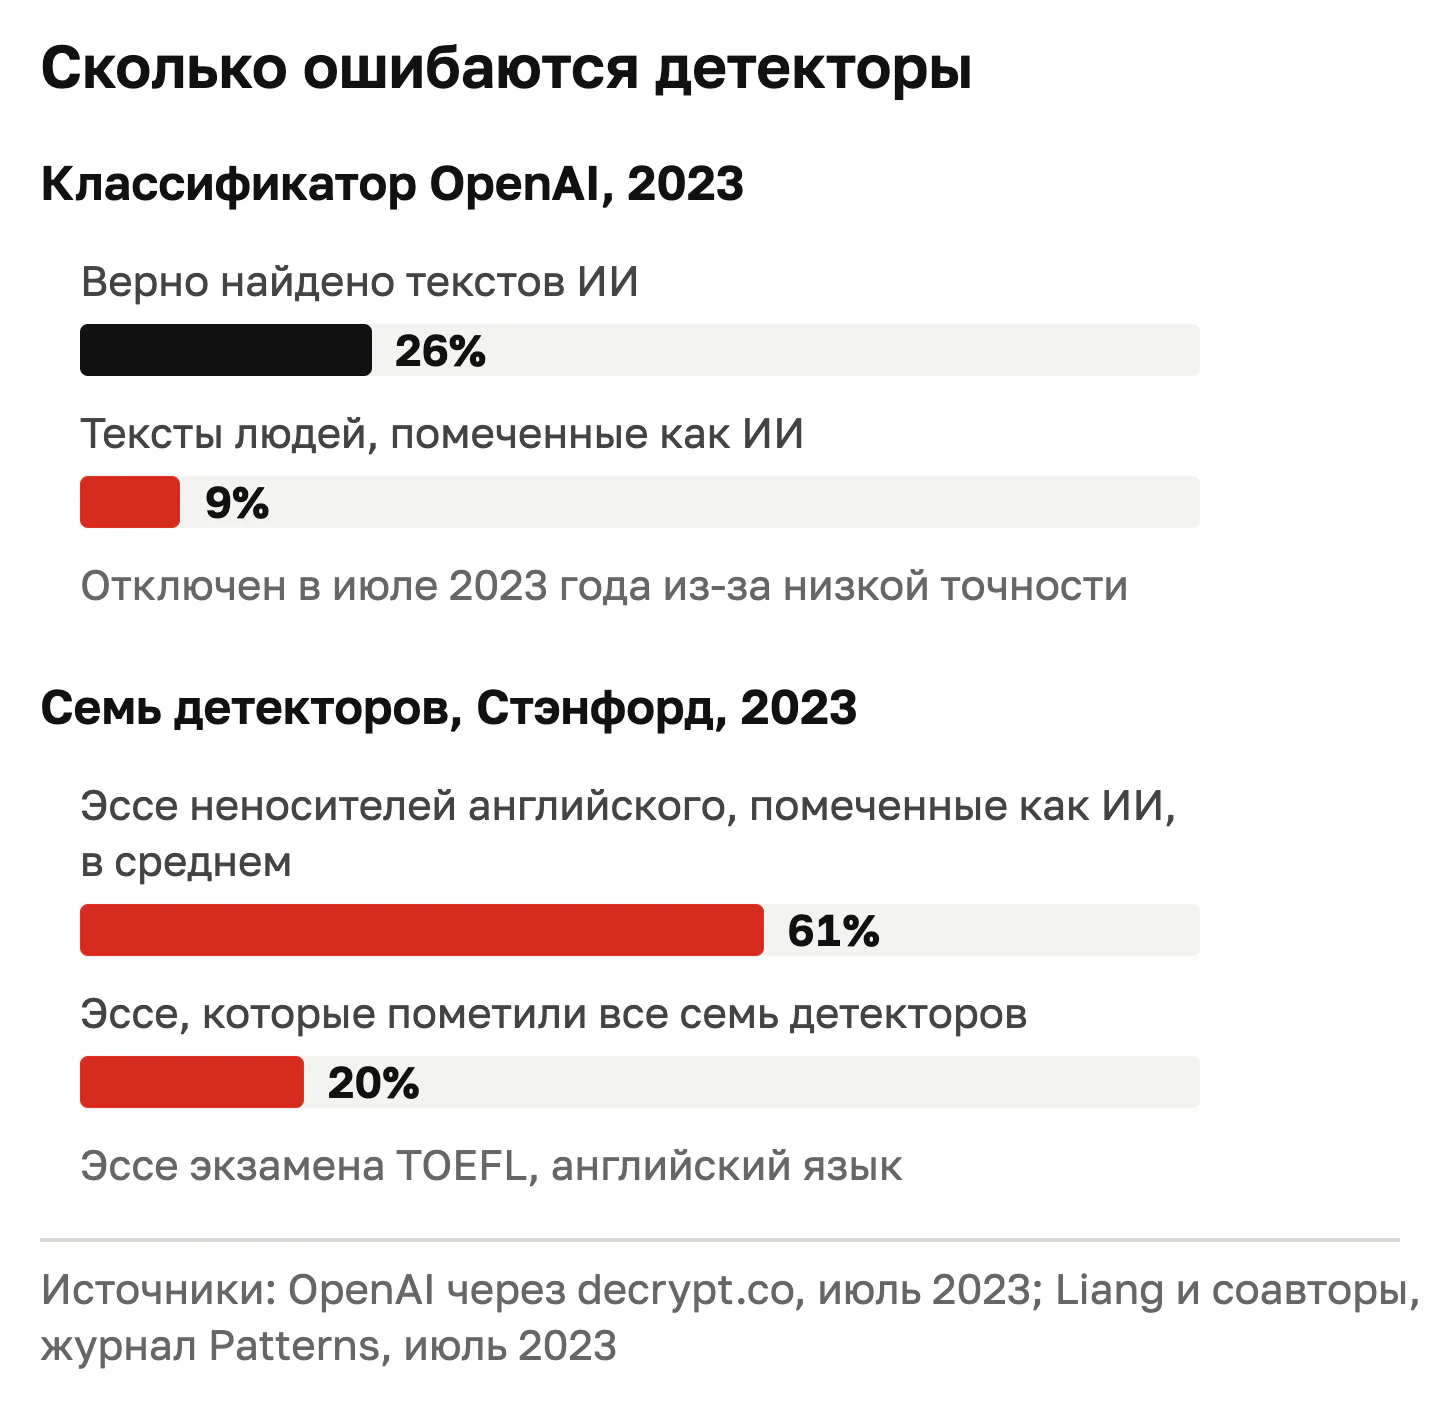
Признаки ловят сырой ответ модели. После правки он дает обратную ошибку: теряет заходы и ровный ритм, и его перестают узнавать и редактор, и детектор. В том же исследовании Стэнфорда эссе, которые ChatGPT по просьбе переписал «литературным языком», семь детекторов почти перестали узнавать: до правки лучшие из них находили до 100% таких эссе, после правки не больше 13%.
Один признак - повод перечитать абзац внимательнее. Если признаков три-четыре в одном абзаце и картина повторяется от раздела к разделу, текст, скорее всего, вышел из модели без правки. Вердикт по одному признаку не выносят, особенно когда от него зависят оплата работы или репутация автора.
Как проверить текст на признаки ИИ за десять минут
Порядок рассчитан на статью в 2-4 тысячи слов. Шаги ищут разные признаки, поэтому их проходят подряд и к пройденному не возвращаются.
- Края разделов, 2 минуты. Прочитайте только первую и последнюю фразу каждого раздела. Если почти все начала обещают, а почти все концовки обобщают, пустые заходы и финалы-афоризмы найдены.
- Зачины абзацев, минута. Пробегите глазами первые два-три слова каждого абзаца. Одинаковая схема или связки из списка ИИ-лексики видны сразу.
- Противопоставления, 2 минуты. Поиском по странице найдите «не» с пробелом и запятую перед «а». Для каждой находки задайте вопрос, кто утверждает отвергнутую сторону. Тройки «A, B и C» попадутся по дороге.
- Ритм, минута. Уменьшите масштаб страницы так, чтобы слова нельзя было разобрать: абзацы одной длины превратятся в одинаковые прямоугольники. Потом прочитайте вслух два абзаца подряд.
- Стоп-слова, 2 минуты. Проверьте поиском слова «является», «данный», «в рамках», «ключевой», «стоит отметить», «в свою очередь». Одно вхождение на статью ничего не значит, смотрите на плотность.
- Факты, 2 минуты. Найдите числа, названия, даты и источники, которые нельзя придумать, и проверьте два-три из них. Если проверяемых деталей нет совсем, это подозрительнее любых штампов. Google просит вручную проверять факты во всем контенте, созданном с помощью ИИ, включая title, description, структурированные данные и alt (проверено 10.11.2026).
Записывайте по ходу номер абзаца и признак. Подрядчику список из десяти конкретных мест объяснит больше, чем общее «похоже на нейросеть», и спорить с таким списком сложнее.
После ручного прохода можно подсветить признаки в своем тексте инструментом сайта. Он ищет шаблонные формулировки и ровный ритм, считает балл от 0 до 10 и раскрашивает найденное по категориям. От 8,5 балла текст считается авторским. При 7-8,4 в тексте осталось несколько машинных связок, ниже 5 фрагменты придется переписать. Ритм инструмент оценивает только на длинных фрагментах, для точной оценки нужно хотя бы 80 слов (проверено 10.11.2026).
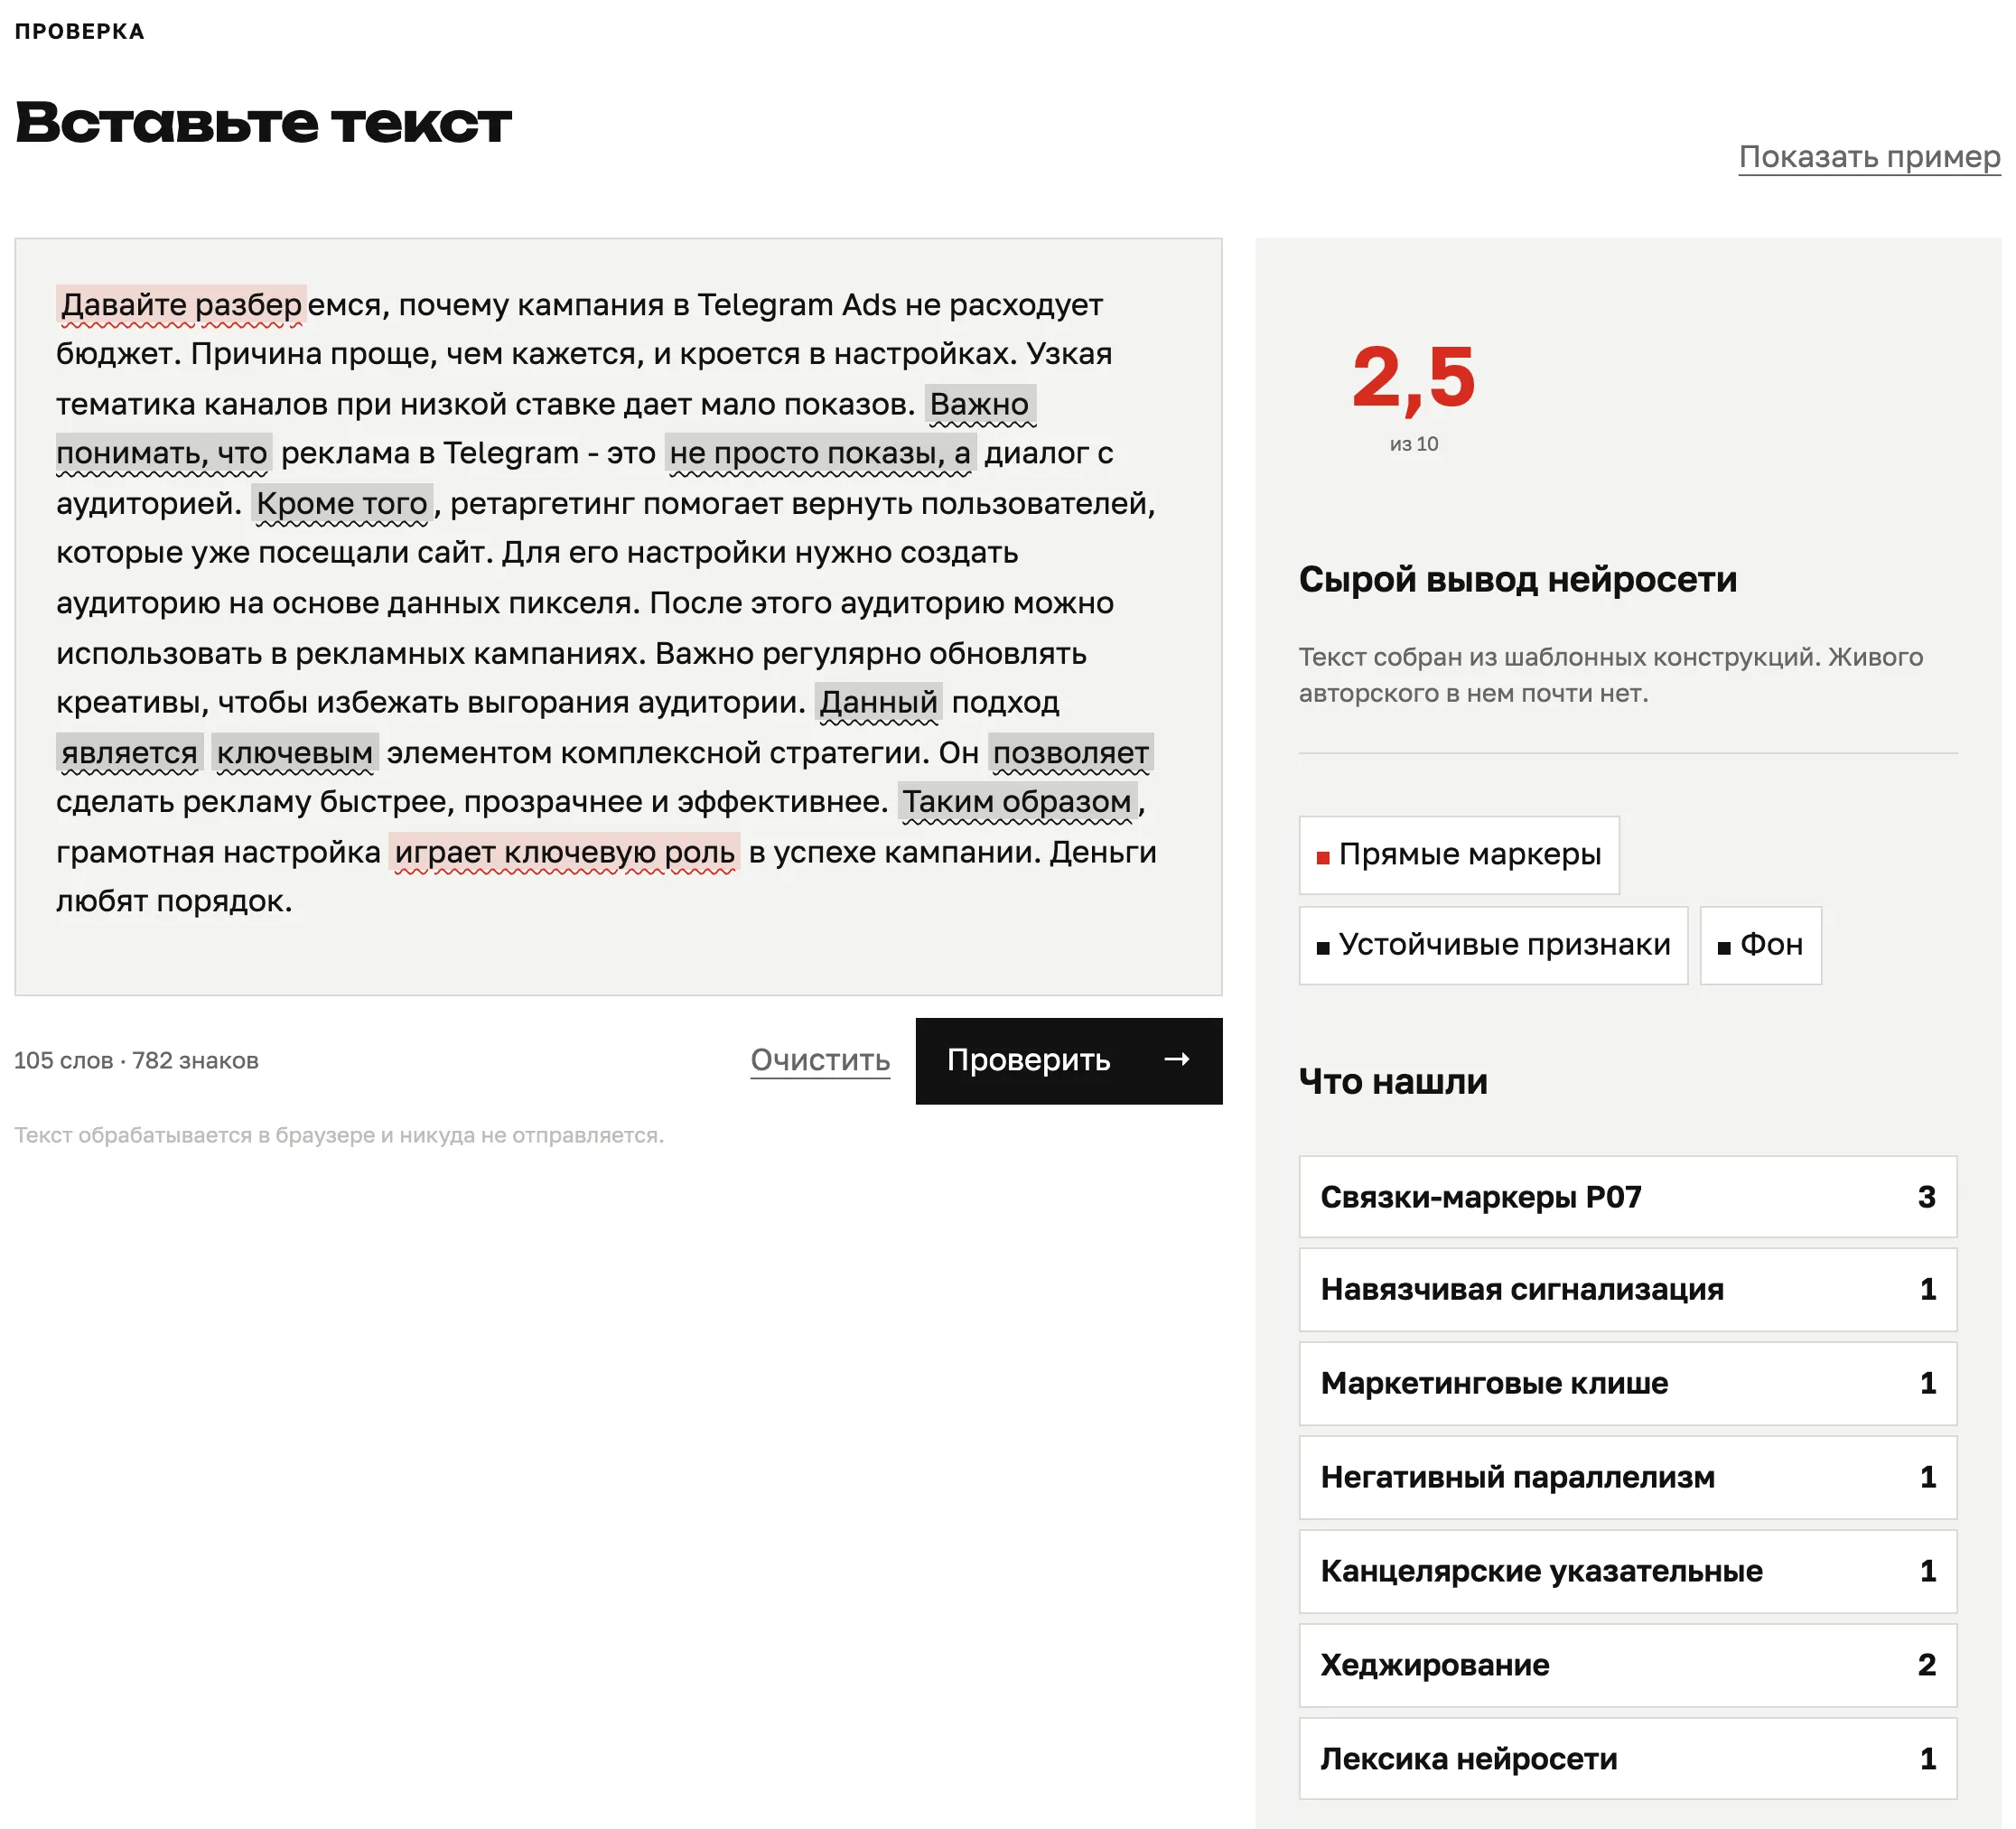
Балл не устанавливает авторство: он отражает плотность признаков в тексте. Им удобно сравнивать две версии одного текста, до правки и после.
Для своего текста следующий шаг - правка. Ее ведут сверху вниз, от структуры к словам: как очеловечить текст после нейросети. С текстом подрядчика список мест пригодится при приемке. Что заложить в задание заранее и как принимать текст у копирайтера, разобрано в отдельной статье.
Коротко
- Текст нейросети узнается по восьми признакам: пустые заходы, декоративные антитезы и тройки, ровный ритм, финалы-афоризмы, раздутая значимость, ИИ-лексика, канцелярит, повторы с элегантной вариацией.
- По отдельности каждый признак встречается у людей. Сигнал - несколько признаков рядом и та же картина по всей статье.
- Ровный ритм и отсутствие проверяемых фактов выдают текст надежнее слов, синонимайзер их не убирает.
- Детекторы ошибаются в обе стороны. Классификатор OpenAI верно находил 26% ИИ-текстов при 9% ложных срабатываний и был отключен через полгода после запуска. Семь детекторов в исследовании Стэнфорда пометили как ИИ в среднем 61% эссе неносителей английского.
- Google не наказывает за сам факт генерации, нарушение - массовые страницы без ценности. Яндекс относит к малополезному контенту тексты, которые выглядят автоматически сгенерированными или не несут дополнительной ценности.
- Вручную статью проверяют за десять минут: края разделов, зачины абзацев, противопоставления, ритм, стоп-слова, факты.
Частые вопросы
Какие признаки ИИ в тексте самые надежные?
Из восьми признаков надежнее всего ровный ритм: замена слов его не трогает, длина предложений остается прежней. Второй надежный сигнал лежит за пределами стиля: в тексте нет проверяемых фактов, и синонимы их не добавят. Пустые заходы и финалы-афоризмы после замены слов тоже остаются, их видно по первой и последней фразе раздела.
Сколько признаков нужно, чтобы считать текст машинным?
Одного мало. Любой из восьми можно найти в тексте, который писал человек. Рабочий порог редактора - три-четыре признака в одном абзаце и повтор той же картины в нескольких разделах. Даже тогда вывод говорит о вероятности: так чаще пишет модель, чем человек.
Почему детектор помечает текст человека как написанный ИИ?
Многие детекторы опираются на предсказуемость текста. Предсказуемо пишут аккуратные редакторы, авторы деловых текстов и неносители языка: у них ровная грамматика и привычные обороты. В исследовании Стэнфорда семь детекторов пометили как ИИ в среднем 61% эссе TOEFL, написанных неносителями английского. Классификатор OpenAI ошибочно считал машинными 9% текстов людей.
Наказывают ли поисковики за текст, написанный нейросетью?
За сам факт генерации нет. Google считает нарушением массовое создание страниц без ценности для читателя (политика scaled content abuse) и просит вручную проверять факты во всем ИИ-контенте. Яндекс в справке Вебмастера относит к малополезному контенту текст, который выглядит автоматически сгенерированным или не несет дополнительной ценности. Такой текст, уточняет Яндекс, часто делают нейросетью или машинным переводом без анализа и редактуры. Среди признаков такого текста Яндекс называет уход от темы, предложения ради объема, поверхностные рассуждения по заголовку и непроверенные факты, поданные как достоверные (проверено 10.11.2026). Как нейросети проверяют экспертизу, разобрано в статье что поисковики оценивают в авторе.
Что за список признаков ИИ-текста в Википедии?
Это руководство-памятка «Signs of AI writing» в английской Википедии. Правилом Википедии оно не считается. Ведет его проект WikiProject AI Cleanup, который с 2023 года ищет и чистит правки, сделанные моделями. В руководстве описаны обороты и приемы, по которым такие правки узнаются: преувеличенная значимость, поверхностный анализ с деепричастным оборотом в конце фразы, перечисление мелких упоминаний в СМИ, антитезы и правило трех. Рекламный язык из действующих признаков убран: им чаще грешили модели 2023-2025 годов (проверено 10.11.2026). На автоматические детекторы составители советуют не опираться в одиночку: они работают лучше случайного угадывания, но часто ошибаются. В русской Википедии с октября 2025 года есть свое эссе «Признаки сгенерированности текста». Часть признаков привязана к энциклопедическому стилю, поэтому для русского маркетингового текста список нужно дополнять своей ИИ-лексикой и своими связками.