Как очеловечить текст после нейросети и убрать признаки ИИ

Сервисы-очеловечиватели меняют слова и оставляют каркас, по которому машинный текст узнается: ровный ритм, абзацы одного размера, пустые заходы. В нашей проверке два бесплатных сервиса подняли балл фрагмента с 2,5 до 7,1 и 8,6 из 10, а выдуманная статистика в нем осталась. Черновик нейросети правят сверху вниз, от фактов и структуры к словам. Часть работы снимает инструкция модели до генерации. Готовый текст проверяют чтением вслух и подсветкой признаков в инструменте, но гнаться за баллом не нужно.
Нейросеть выдает черновик статьи за пару минут, и первый абзац читается гладко. К третьему разделу становится понятно, кто писал. Признаки ИИ-текста мы разобрали в отдельной статье.
Убирают их правкой, и порядок в ней важнее списка замен: слова меняют в последнюю очередь. Часть работы можно отдать самой модели, если задать ей правила до того, как она начнет писать.
Почему сервисы-очеловечиватели не решают задачу?
Сервис-очеловечиватель, он же рерайтер или гуманизатор, переписывает готовый текст. Простые сервисы подбирают синонимы и переставляют части предложений, сервисы на основе языковых моделей перефразируют предложения целиком. Некоторые добавляют опечатки и разговорные вставки, чтобы сбить детектор (разбор 19 таких сервисов на arXiv, январь 2025).
Читатель узнает машинный текст по другим признакам. Абзацы одного размера, и в каждом одна схема: тезис, пояснение, вывод. У разделов анонс на входе и финал-афоризм на выходе. Мысль от первого раздела до последнего идет по одному маршруту, без отступлений и возвратов. Замена синонимов этого не касается. Перефразирование по предложениям сохраняет порядок абзацев и мыслей.
Вторая беда - термины. Сервис не знает, что в вашей отрасли у слова точный смысл, и берет близкое по словарю. В тексте о рекламе «охват» может стать «покрытием», «конверсия» - «преобразованием», а «отказ» - «отклонением». Последняя замена меняет факт: в веб-аналитике отказ - это короткий визит, после которого человек ушел с сайта, а объявления отклоняет модерация рекламной площадки. Поэтому после сервиса текст приходится заново сверять с источниками.
Мы взяли два бесплатных сервиса из выдачи по запросу «очеловечить текст онлайн», оба без регистрации, и 10.11.2026 прогнали через них типичный ответ модели о выборе Telegram-канала для рекламы. В инструменте проверки текста балл по шкале от 0 до 10 вырос с 2,5 до 7,1 у первого сервиса и до 8,6 у второго. Этот же ответ разобран в примере правки.
Каркас при этом не изменился. Оба сервиса сохранили абзац-анонс в начале («Мы посмотрим, что важно», «Ниже описано, на что нужно смотреть») и вывод в конце с тем же противопоставлением «не просто найти место, где много людей». Выдуманная статистика тоже осталась: второй сервис оставил «в 80 % случаев», первый убрал число, а утверждение без источника сохранил.
Второй вдобавок выбросил целый абзац о проверке канала на накрутку. Первый превратил «репосты» в «что делятся», накрученных подписчиков в «мертвые души» и сменил тон на «Telegram - классная штука для рекламы».
Похожий вывод приводит Skillbox Media в разборе от 27.10.2025: журналист и преподаватель Эрик Офганг проверил несколько англоязычных сервисов, они немного улучшили текст, но результат остался похож на ИИ-контент (skillbox.ru).
Что задать нейросети до генерации
Модель без входных данных пишет самое вероятное. Попросите ее написать о рекламе в Telegram, и получите то, что чаще всего встречается в текстах о рекламе в Telegram: общие советы и круглые цифры без источника.
По руководству Google о генеративном ИИ, модель помогает изучить тему и выстроить структуру материала, а точность фактов проверяет человек (developers.google.com, страница обновлена 01.10.2026, проверено 10.11.2026).
Что стоит положить в инструкцию:
- Числа с источником и датой, случаи из практики, названия кнопок и разделов интерфейса. Это фактура, и с ней модель меньше додумывает.
- Список запрещенных слов и конструкций. Просьба «пишите по-человечески» почти ничего не говорит модели, конкретный список работает лучше.
- Кто читатель, что он уже знает и как к нему обращаться. Без этого модель объясняет базу, которую ваш читатель знает лучше нее.
- План с разной длиной разделов, например «раздел 1 - около 150 слов, раздел 2 - около 400». Одинаковый объем в инструкции дает одинаковые разделы в ответе.
- Запрет придумывать цифры. Если цифры нет во фактуре, модель задает автору вопрос, а в тексте не оставляет ни своей догадки, ни пометки.
Фрагмент нашей рабочей инструкции для модели, в сокращении:
Пишите только по-русски. Букву «е» с точками не используйте, длинное тире тоже: вместо него короткий дефис. Кавычки - «елочки». К читателю обращайтесь на «вы».
Удаляйте вместе с предложением анонсы того, что сейчас будет сказано («и тут выясняется», «но есть нюанс», «а теперь самое главное»), пустые открытия («в современном мире», «не секрет, что») и ссылки на неназванных экспертов («эксперты считают», «исследования показывают»). Если источник есть, назовите его, если нет, уберите утверждение.
Не используйте «является», «позволяет», «представляет собой», «кроме того», «таким образом», «стоит отметить», «играет ключевую роль», «данный». Противопоставление «не X, а Y» ставьте только там, где есть контраст по смыслу.
Чередуйте длину предложений и абзацев. Часть предложений только сообщает факт, без претензии на вывод. Пункты списка начинайте с разных слов.
Цифры берите только из фактуры и ставьте рядом дату проверки. Где фактуры не хватает, задайте автору 3-7 конкретных вопросов, а в тексте пометок не оставляйте.
Если текст пишет человек, те же правила превращаются в техническое задание со стоп-листом и критериями приемки, как в ТЗ копирайтеру на SEO-текст.
Правка после инструкции остается. Запреты на слова модель соблюдает лучше, чем требования к ритму, и даже с подробной инструкцией часто выдает абзацы похожей длины и одинаковые переходы между разделами.
Вторым запросом модель можно попросить проверить собственный текст по тому же списку запретов. Она уберет часть запрещенных слов, но нередко поставит на их место соседние маркеры: вместо «кроме того» появится «помимо этого». Для чернового прохода этого хватает.
Порядок правки: от структуры к словам
Черновик правят сверху вниз, от того, что держит текст целиком, к отдельным словам. Если начать со слов, можно час шлифовать предложения, которые на шаге структуры уйдут вместе с абзацем. Зато правка структуры сама убирает часть словесных маркеров, ведь вместе с абзацем-анонсом из текста уходит и его «давайте разберемся».
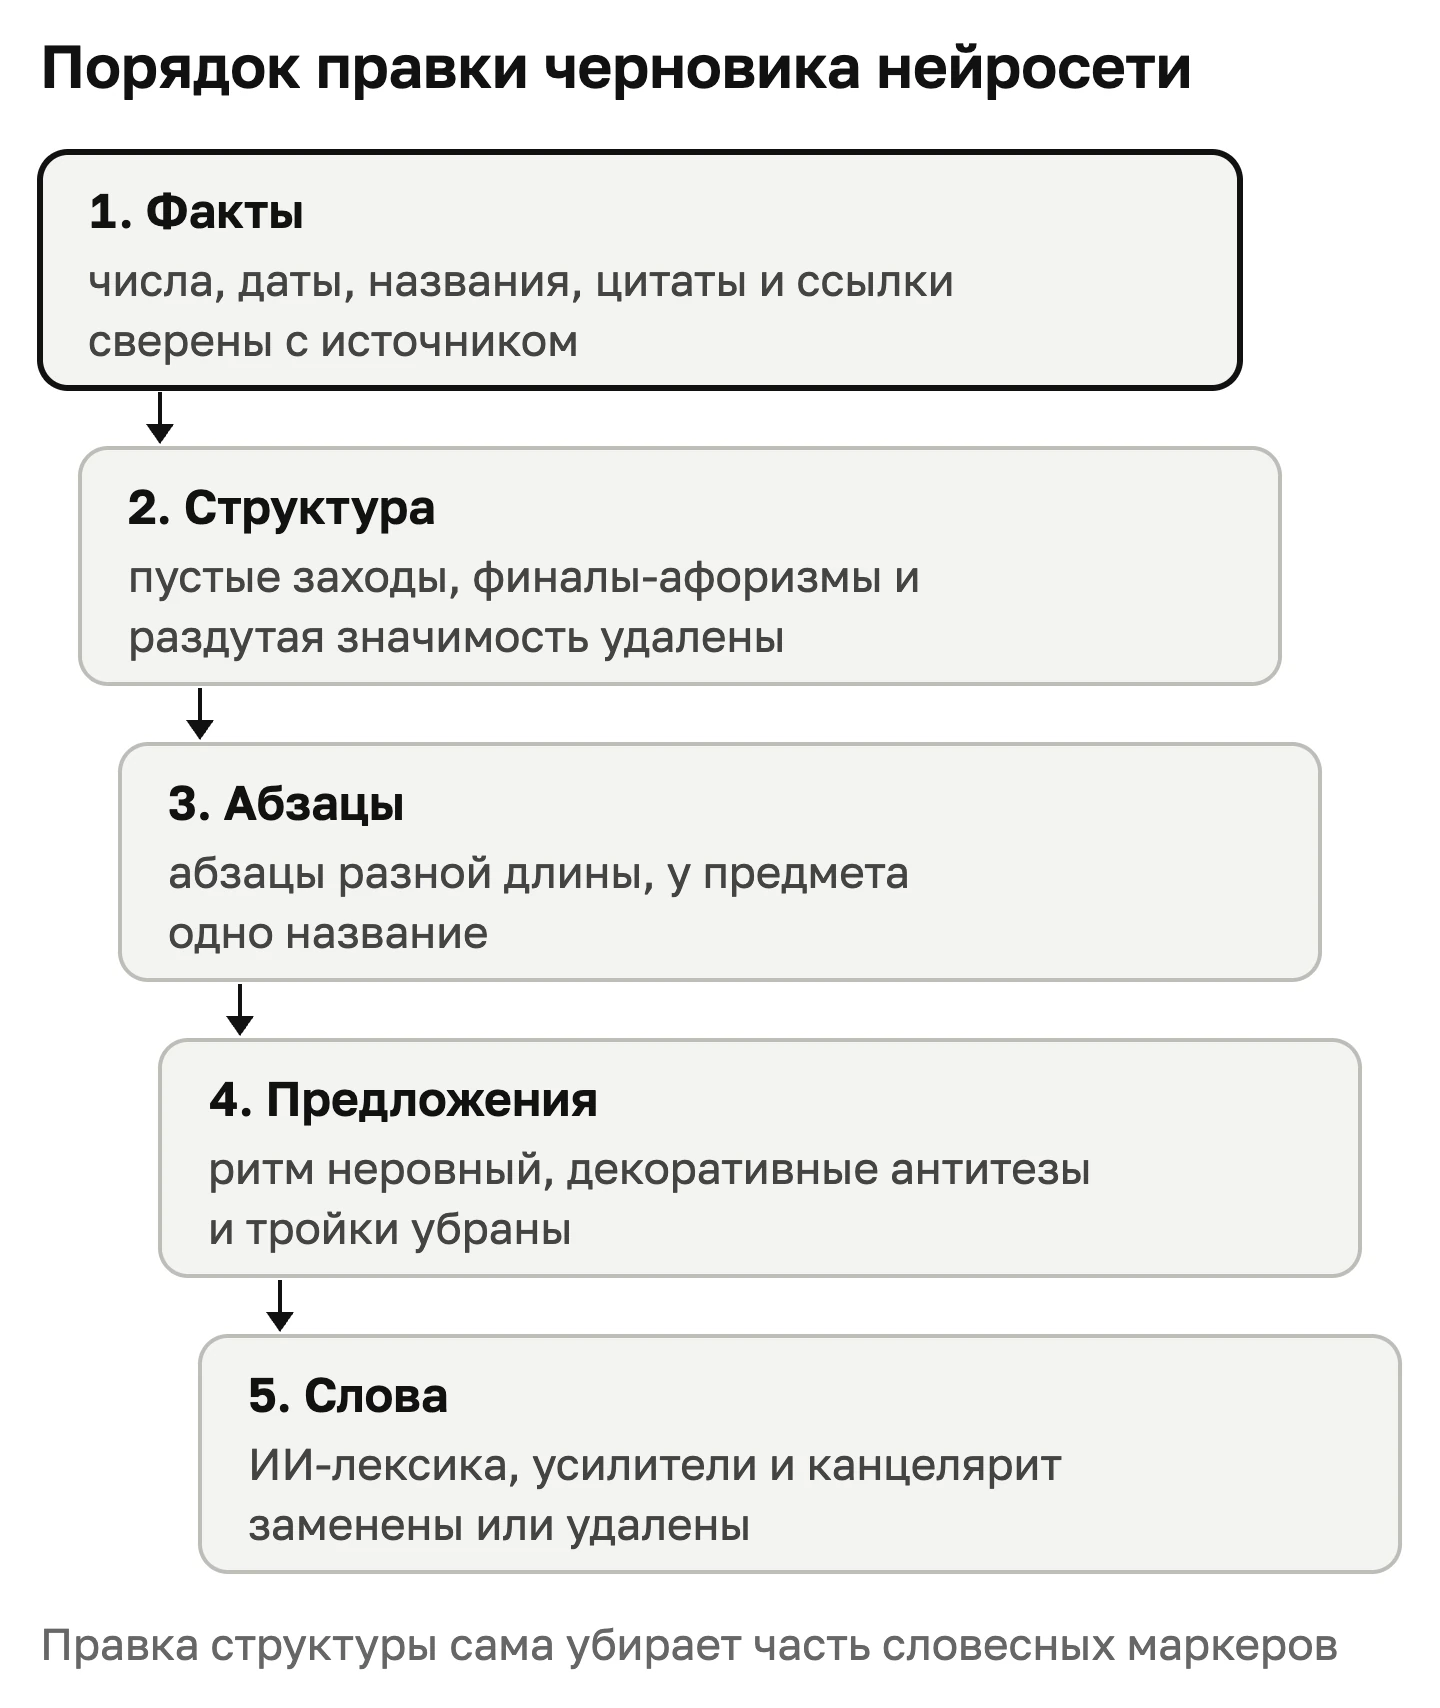
Факты
Отметьте в черновике каждое число, дату, название, цитату и ссылку и сверьте их с источником. Что не подтвердилось, удаляйте вместе с предложением. Факты идут первыми, потому что от них зависит, останется ли раздел вообще: если единственная цифра в нем выдумана, стиль править незачем.
Структура
Прочитайте подряд только заголовки и первые предложения разделов и проверьте, отвечает ли каждый раздел на вопрос из своего заголовка. Если ответ начинается со второго абзаца, первый, скорее всего, пустой заход, и его удаляют целиком. Последний абзац, который пересказывает раздел одной фразой или звучит как лозунг, тоже уходит, как и предложения, раздувающие значимость темы: «это меняет подход к рекламе». Два раздела об одном и том же сливают в один.
Чтобы нейросети брали из раздела фрагменты в ответы, его строят по отдельным правилам. Они описаны в материале о структуре текста под цитирование.
Абзацы
Модель пишет абзацы одного размера и по одной схеме. Оставьте один абзац в одно предложение, соседний сделайте длиннее, а абзацы, которые повторяют одну мысль, сведите в один. На этом же шаге ловят элегантную вариацию: модель избегает повторять слово и называет один предмет то «инструментом», то «решением». В рабочем тексте у предмета одно название, и читатель не гадает, о двух вещах речь или об одной.
Предложения
Здесь ищут ровный ритм и цепочки одинаковых конструкций вроде «Воронки ведут себя иначе. Аудитория реагирует иначе.» Такие пары сливают в одно предложение или перестраивают. Антитезу вида «не X, а Y» там, где противопоставлять нечего, разворачивают в прямое утверждение: «Это не про ключевые слова, это про формулировки» становится «Тут решают формулировки». Однородные тройки, где третье слово добрано для ровного звучания, сокращают до одного-двух слов, за которыми стоит факт.
Слова
Последним идет словарь: ИИ-лексика, пустые усилители, канцелярит и отглагольные существительные. Их к этому шагу меньше, ведь часть ушла вместе с абзацами и предложениями.
Как сделать ритм текста неровным
Ровный ритм выдает машину даже там, где нет ни одного запрещенного слова. Абзац из пяти предложений по 12-15 слов читается как машинный уже на третьей строке, хотя придраться в нем не к чему.
Приемы для русского текста:
- Слейте два коротких предложения в одно длинное через «если», «потому что» или «пока».
- После длинного предложения поставьте короткое, в три-шесть слов.
- Начинайте абзац с числа, названия или действия вместо вводного слова.
- Пункты списка делайте разной длины и с разными первыми словами.
Отдельно смотрите на списки. Модель охотно раскладывает по пунктам то, что читается как связная мысль с причиной и следствием, и строит каждый пункт по одной схеме: существительное, двоеточие, пояснение. Если пункты связаны между собой, их лучше собрать обратно в абзац. Список оставляют там, где читатель будет по нему что-то сверять или выполнять по шагам.
На статью в 3 000 слов хватает 4-8 мест, где ритм заметно меняется. Если дробить все абзацы на фразы по пять слов, текст становится рубленым, и это тоже узнаваемо: модели пишут отрывисто, стоит только попросить.
Пример одного абзаца до и после:
До правки
Отчет по рекламе нужно проверять каждую неделю. В отчете важно смотреть на цену заявки и число заявок. Если цена заявки растет, нужно искать причину в кампаниях. Чаще всего причина связана с креативами или аудиторией. После анализа можно принимать решение об изменениях.
После правки
Отчет по рекламе открывают раз в неделю и сначала смотрят на две цифры: сколько пришло заявок и сколько стоила каждая. Цена выросла - открывайте кампании. Причину обычно видно сразу: креатив крутится слишком долго, аудитория сузилась после правки настроек или в аукцион зашел конкурент. Что менять, решают после этого.
В первой версии пять предложений по 7-10 слов, и в четырех из них стоят «нужно», «важно» или «можно». Во второй длина от четырех слов до двадцати, а модальные слова заменены действиями.
Чем заменить ИИ-лексику и канцелярит
Один маркер не меняют на другой. Если заменить «таким образом» на «в итоге» по всему тексту, получится тот же шаблон с новым словом. Часто лучшая замена - удалить слово, предложение работает и без него.
| Было | Стало | Почему |
|---|---|---|
| «Метрика является показателем качества» | «Метрика показывает качество»; в определении тире: «Кликабельность - доля кликов от показов» | Связка без действия, глагол возвращает смысл |
| «позволяет» | «дает», «можно» или прямой глагол | Прячет, кто и что делает |
| «представляет собой» | тире или «это» | Два слова там, где хватает знака |
| «осуществить внедрение», «провести анализ» | «внедрить», «проанализировать» | Действие спрятано в существительное |
| «играет ключевую роль» | что делает: «дает половину заявок» | Оценка без факта |
| «ключевой», «важный» | признак: «главный по заявкам», «первый по расходу» или ничего | Важность видна по факту, слово ее не добавляет |
| «данный» | «этот», «такой» или ничего | Канцелярит |
| «кроме того», «таким образом» | удалить; в меру «еще», «поэтому» | Связь и так понятна из смысла, связка ее только объявляет |
| «эффективный», «реальный», «настоящий» | цифра результата или ничего | Усилитель без содержания |
Канцелярит в черновиках нейросетей сидит в отглагольных существительных: «проведение анализа», «осуществление контроля», «обеспечение роста». Глагол возвращает в предложение того, кто действует: «проанализировали», «следит», «растет».
Еще одна группа - кальки, которые модель переносит из англоязычных текстов: «ландшафт рынка», «вызовы», «на ежедневной основе». В русском деловом тексте у них есть простые замены: «рынок», «трудности» или «задачи», «каждый день».
Список замен удобно вести один на все тексты: слова, которые вы вычеркиваете чаще других, и то, что ставите вместо них. Тот же список потом уходит в инструкцию модели, и в следующем черновике этих слов будет меньше.
Что делать с фактами и цифрами из ответа нейросети
Языковая модель предсказывает вероятную последовательность слов, а факты из базы не достает. Поэтому она может уверенно написать цифру, похожую на правду, или название кнопки, которой нет в интерфейсе. Google пишет об этом в том же руководстве и просит вручную проверять факты во всем, что создано с помощью ИИ, включая title, description, структурированные данные и alt-тексты картинок (developers.google.com, проверено 10.11.2026; разбор требования на ppc.land).
На этом сайте каждую цифру сверяют по двум независимым источникам и ставят рядом дату проверки. В черновике нейросети проверяют пять групп данных:
- Числа и проценты. Ищут первоисточник. Круглая цифра без привязки вроде «в 80% случаев» удаляется, если источник не нашелся. Подбирать источник под готовую цифру нельзя.
- Названия кнопок, разделов и настроек. Их сверяют с интерфейсом, потому что модель может назвать раздел по-старому или перевести английское название по-своему.
- Ссылки. Каждую открывают. Модель умеет собрать правдоподобный адрес из кусков существующих адресов, и он ведет на ошибку 404.
- Даты и сроки. Акции, переходные периоды и временные лимиты помечают датой окончания, чтобы вовремя убрать.
- Цитаты и фамилии экспертов. Если оригинал не нашелся, цитата уходит.
Источник, который назвала сама модель, тоже проверяют: она может сослаться на исследование, которого нет, или приписать цифру не тому изданию.
Перед правкой сохраните копию черновика, а после сравните, совпадают ли в двух версиях списки чисел и ссылок. Переписывая предложение, легко потерять цифру или сбить адрес, и сравнение списков показывает такие потери сразу. Мы делаем это коротким скриптом. На небольшом тексте хватит поиска по цифрам.
Если факт не подтвердился, а мысль нужна, утверждение сужают до того, что известно. Вместо выдуманного процента остается наблюдение без числа или ваш собственный замер с датой и объемом выборки.
За саму генерацию Google не наказывает. Нарушение по его правилам - массовое создание страниц без ценности для читателя (политика scaled content abuse). Позицию Яндекса мы собрали в разборе признаков ИИ-текста. Подробнее о поиске и машинном тексте мы писали в материале о том, что такое SEO-текст.
Пример правки одного фрагмента: до и после
Задание модели: «Напишите абзац для блога о том, как выбрать Telegram-канал для рекламы, 150-200 слов». Фактуры у модели не было. Первая колонка - типичный ответ, вторая - тот же фрагмент после правки по пяти шагам.
Ответ модели
В современном мире Telegram является одной из самых популярных платформ для продвижения бизнеса. Однако выбор канала для размещения рекламы представляет собой непростую задачу, и здесь важно учитывать множество факторов. Давайте разберемся, на что стоит обратить внимание.
Прежде всего необходимо оценить аудиторию канала. Количество подписчиков играет ключевую роль, но это далеко не единственный показатель. Не менее важна вовлеченность аудитории: реакции, комментарии и репосты. По статистике, в 80% случаев каналы с высокой вовлеченностью показывают лучшие результаты рекламных кампаний.
Кроме того, стоит обратить внимание на тематику канала и ее соответствие вашему продукту. Важно, чтобы интересы подписчиков совпадали с интересами вашей целевой аудитории. Реклама в канале, далеком от вашей ниши, вряд ли принесет желаемый результат.
Также важно проверить канал на накрутку. Для этого можно использовать специализированные сервисы аналитики, которые позволяют оценить динамику роста подписчиков.
Таким образом, грамотный выбор канала - это не просто поиск площадки с большим охватом, а комплексный анализ множества параметров. Правильный подход позволит вам значительно повысить эффективность рекламных вложений.
После правки
Перед оплатой рекламы в канале проверьте две вещи: читают ли его и те ли люди читают.
Читаемость видно по охвату. Средний охват поста делят на число подписчиков, в TGStat эта доля называется ERR. У каналов от десятков тысяч подписчиков рабочий диапазон 5-15%. Ниже 5% канал почти никто не читает, а при ERR выше 20-25% у крупного канала стоит открыть почасовой график просмотров: такую цифру дает и пост, который разошелся пересылками, и купленные просмотры. Одну цифру без контекста не оценивают, канал сравнивают с 3-5 соседями той же темы и размера.
Аудиторию проверяют по содержанию: о чем последние посты и кто пишет в комментариях. Если под постами про инвестиции обсуждают розыгрыши, ваш продукт там тоже обсуждать не станут.
Если вы покупаете показы через Telegram Ads, нижний порог задает площадка: в каналах спонсорские сообщения показываются только в публичных, от 1 000 подписчиков, а пользователи Telegram Premium по умолчанию их не видят (ads.telegram.org и telegram.org, проверено 10.11.2026).
Что изменилось по шагам:
- Факты. Цифра «в 80% случаев» без источника удалена. На ее месте пороги ERR из нашего разбора проверки Telegram-канала (проверено 10.11.2026) и условие площадки с датой проверки.
- Структура. Ушли пустое открытие, анонс «давайте разберемся» и последний абзац-вывод. Абзац о тематике слился с проверкой аудитории.
- Абзацы. Вместо пяти абзацев похожего размера четыре разной длины, от одного предложения до пяти.
- Предложения. Антитеза «не просто поиск площадки, а комплексный анализ» удалена вместе с выводом. Короткое «Читаемость видно по охвату.» стоит рядом с длинным предложением про пороги.
- Слова. «Является», «представляет собой», «играет ключевую роль», «кроме того», «таким образом», «позволяют» ушли вместе со своими предложениями, замен для них не понадобилось.
Как понять, что текст больше не читается как ИИ
Сначала прочитайте текст вслух, начиная с середины: начало вы правили внимательнее всего. Где голос начинает идти по кругу, там ровный ритм. А фразу, которую приходится перечитывать, стоит разбить.
Потом пройдите по шагам проверки текста за десять минут: края разделов, зачины абзацев, противопоставления, ритм, стоп-слова, факты. Каждый найденный признак отправляет вас на шаг правки, который его убирает.
Полезно отдать текст коллеге, который не знает, как его писали, и попросить отметить места, где стало скучно или пришлось перечитать. Пометки коллеги показывают то, что автор перестает замечать после нескольких проходов по тексту.
В инструменте сайта можно проверить балл до и после правки. Шкала от 0 до 10, авторским считается текст от 8,5 балла, а ниже 5 фрагменты переписывают. Текст короче 80 слов получает приблизительную оценку, а ритм инструмент считает только на длинных фрагментах (страница инструмента, проверено 10.11.2026).
Фрагмент из примера до правки набрал 2,5 балла: инструмент нашел в нем 11 срабатываний в семи категориях, в том числе пустое открытие и круглую цифру без источника. После правки балл 10. Ритм на обоих фрагментах инструмент не оценил, им не хватает длины, поэтому разницу дали одни формулировки.
Гнаться за десяткой не нужно. Второй сервис-очеловечиватель из нашей проверки получил 8,6, то есть по баллу текст читается как авторский, а выдуманные 80% в нем остались. Балл говорит о плотности признаков и автора не называет. Шаблонный текст человека получит низкую оценку, вычитанный ответ модели - высокую. Подсветка помогает найти места, которые вы пропустили глазами, а что делать с каждым местом, решаете вы.
Коротко
- Сервисы-очеловечиватели меняют слова, а машинный текст узнается по каркасу: ритму, одинаковым абзацам, заходам и концовкам разделов.
- Инструкция модели до генерации сокращает правку: фактура на входе, список запретов, портрет читателя, разная длина разделов, запрет придумывать цифры.
- Порядок правки: факты, структура, абзацы, предложения, слова. Слова идут последними, потому что часть их уходит вместе с абзацами.
- Ритм меняют в 4-8 местах на статью, и текст при этом не должен стать рубленым.
- Один маркер не заменяют другим, часто лучшая замена - удалить слово.
- Каждую цифру сверяют по двум источникам и ставят дату проверки, круглые цифры без источника удаляют.
- Результат читают вслух, проходят по признакам и смотрят балл в инструменте. Подсветка показывает места для правки, а что с ними делать, решает редактор.
Частые вопросы
Можно ли очеловечить текст онлайн-сервисом?
Сервис заменит слова и переставит части предложений, но абзацы останутся одного размера, а разделы по-прежнему открываются анонсом и закрываются выводом. По этим признакам машинный текст и узнают. Мы прогнали ответ модели через два таких сервиса: балл вырос с 2,5 до 7,1 и 8,6 из 10, а анонс и выдуманная статистика остались. Вдобавок сервис может заменить термин синонимом, который в вашей отрасли значит другое, поэтому после сервиса термины и цифры проверяют еще раз. Надежнее править вручную по порядку: факты, структура, абзацы, предложения, слова.
Какой промпт дать нейросети, чтобы текст звучал по-человечески?
Одной фразы вроде «пишите как человек» мало: модель не знает, что вычеркивать. Рабочая инструкция включает фактуру с источниками, список запрещенных выражений, обращение и портрет читателя, план с разной длиной разделов и запрет придумывать цифры. Даже с такой инструкцией черновик потребует правки, но ее будет меньше.
Сколько времени занимает правка текста после нейросети?
Время правки зависит прежде всего от числа фактов в тексте: каждую цифру нужно найти в двух источниках, а каждую ссылку открыть. Структура и слова правятся быстрее. Если модель получила фактуру на входе, на проверку уходит меньше времени, потому что источники уже собраны.
Пройдет ли отредактированный текст проверку на ИИ?
Обещать этого нельзя. Детекторы ошибаются в обе стороны: пропускают машинный текст и помечают как машинный текст человека. По данным Стэнфорда для английского языка, чаще других под подозрение попадают тексты неносителей. Цифры точности детекторов собраны в разборе признаков машинного текста. Цель правки - текст, который читатель воспринимает как авторский. Детектор дает только повод перечитать текст. Места для правки показывает подсветка признаков.
Нужно ли указывать, что текст написан с помощью ИИ?
Google советует рассказывать читателю, как создан контент, если часть его сгенерирована автоматически, и делать это в форме, понятной вашей аудитории (developers.google.com, проверено 10.11.2026). Для статьи хватит строки об авторе и о том, как готовился материал. Требования к маркировке в законах разных стран различаются. В ЕС с 2 августа 2026 года действует статья 50 AI Act: о том, что текст на общественно значимую тему создан ИИ, сообщают читателю, кроме случаев, когда текст прошел редакторскую проверку и за публикацию отвечает конкретный человек или компания. В России закон № 243-ФЗ с 1 марта 2027 года дает автору право пометить созданные нейросетью аудио- и визуальные материалы, обязанности маркировать тексты в нем нет (проверено 10.11.2026). Как авторство связано с доверием поисковиков и нейросетей, разобрано в материале про E-E-A-T.